 2026, Vol. 16


——


2. 上海人工智能实验室;
3. 上海交通大学网络信息中心;
4. 复旦大学社会发展与公共政策学院;
5. 昆山杜克大学应用数学与计算科学系;
6. 哥廷根大学计算机研究所;
7. 复旦大学社会智能研究中心
全球科技创新已进入密集活跃期,呈现交叉融合、高度复杂和多点突破的态势[1-2],在此背景下,跨学科研究成为了解决全球性复杂挑战的关键途径,它通过整合不同领域的理论、方法与视角,不仅推动了知识边界的突破,促进了科学组织模式与协作方式的深刻变革,还为应对气候变化、健康危机等全球性问题提供了更全面的解决方案[2-5]。然而,尽管跨学科研究已成为应对复杂科学问题和社会挑战的重要途径,但现有研究仍存在若干关键不足。
早期的跨学科研究主要以定性分析为主,研究者们致力于对“跨学科”的概念进行理论界定[6-7]。在跨学科的概念初步确认后,研究者们通过收集专家的观点[8],开展案例研究[9-10]等方法构建跨学科研究的概念模型[11]与理论框架,探讨知识整合的复杂性,发掘不同学科的边界与潜在的交叉点和合作机会,从而为在实际跨学科研究中如何有效协调和应用多元视角推动该学科发展提出方法支撑。
为了进一步验证跨学科的概念特征和测度跨学科对科学进步的重大影响,科学学、科学计量分析等领域的研究者开始基于数据科学探索研究跨学科研究范式。近年来,国内外学者开发了一系列跨学科的测度指标,试图定量地评估跨学科性。例如通过期刊分类[11]、知识融合度[12]和专业度指标[10,13]来量化研究涉及的学科广度与结合强度,或是通过关键词演变[14]和词频分析[15]来计算特定科学概念在不同领域间出现的频率与共现关系,从而定量追踪知识概念的语义迁移路径。随着数据采集技术的进步和计算能力的提升,大数据的研究范式使得追踪与刻画跨学科的发展历史成为了可能。研究者们通过构建引文网络、知识网络[16-20],计算学科间的连接关系,从而揭示隐藏在数据中的跨学科模式、趋势和关联[21-22]。这些指标为跨学科的定量衡量提供了基础,能够帮助观察某一时间周期内跨学科合作的发展规律及其面临的挑战。
尽管上述相关研究在一定程度上实现了对跨学科的定量衡量,但仍存在局限性。首先,学科范围限制。现有研究主要局限于部分学科领域,缺乏全学科视角的系统性研究,难以全面反映跨学科合作的整体态势[23-25]。同时,由于不同学科的理论和方法存在差异,现有研究在整合多学科方法时常面临冲突,导致测度指标和分析框架的应用范围受限[26-27]。第二,时间跨度有限。现有研究的时间跨度较短,尚缺乏基于长周期、全学科的论文数据来追踪跨学科合作的发展历程和长期趋势。第三,测度角度局限。以往研究主要是在知识层面刻画跨学科特征,采用引文网络、知识网络的测度方法[1,2,4,11,28-29],无法从组织模式、模式转变等方面深度分析跨学科演进发展与科学规律。
针对上述局限性,本研究提出基于团队合作视角下的跨学科研究演化分析框架——通过构建可测量的合作特征指标体系,并结合长周期、大样本、全学科的文献数据,试图回答以下核心问题:①跨学科合作的整体演进趋势如何,跨学科合作在不同学科领域中呈现什么样的发展态势,哪些学科领域间的跨学科合作更具影响力?②如何通过量化识别跨学科合作的特征及模式,不同合作特征下的跨学科合作在研究产出与组织结构上是否存在差异?③跨学科合作的结构是如何随时间推移而变化的,这种结构转变是否能与科技政策、科研范式等外部因素相互作用?
二、研究方法本研究使用的数据来源于智创数据集[30](Intelligent Innovation Dataset
根据本研究提出的问题,先对跨学科的测度方法、论文作者的学科及论文对应的学科组合进行定义。
跨学科的测度:与以往以知识跨度衡量跨学科定义不同[31],本研究更注重于不同学科背景人才的科研合作与团队组合的跨学科合作。本研究将跨学科合作界定为:一篇论文中的合作作者是否来自两个或两个以上不同领域的学科背景。如果是,则认为该论文是由跨学科合作产生的,即称之为跨学科论文,其作者合作组合则被视为跨学科合作组合。因此,涉及两个子概念的衡量。
论文作者学科:每一年份,在单个作者发表的论文集合中,定义该论文集合中出现次数最多的学科为该作者在该年份的学科。考虑到作者的学科可能会随着时间改变,本研究将一个作者在第X年的学科定义为1950-X年的时间区间内他所发文数量最多的学科方向
| $ score=weight\times \frac{total\_ asjc}{total\_ sub\_ id}\times \frac{pub\_ year+1-minyear}{maxyear+1-minyear}\times citednum $ |
论文学科组合:本研究将论文所有作者在发布年份的学科集合定义为该论文的学科组合。
2. 跨学科合作评估维度在跨学科评估的维度测度上,本研究主要从三个维度构建指标,以描绘跨学科合作的发展趋势:学科组合的合作强度通过基于Jaccard的合作强度指标衡量JBS(Jaccard - based Strength);学科组合的研究影响力通过引用中位次数反映MCC(Medium Citation Counts);学科组合的合作规模通过合作者中位数量展示MAC(Median Authors Counts)。
本研究分别计算出每一年份各类学科组合的JBS, MCC, MAC三个指标。
基于Jaccard的合作强度:由于不同学科合作的文献数量与科研活跃度可能存在规模差异,计算机科学、生物医学和物理学等热门学科因其规模较大(例如,研究人员多、论文量大、资源丰富),通常会有更多的合作机会,产生更多的合作论文。而一些较冷门的学科(数学理论、历史学等),由于研究人员数量较少,学科的关注度较低,可能面临较少的合作机会,导致合作频次较低。为避免学科规模差异带来的系统性偏差,采用Jaccard系数构建JBS指标,具体计算公式如下:
| $ Jaccard-basedStrength=\left| A\cap B\ldots \right| /\left| A\cup B\ldots \right| $ |
其中,
目前Jaccard已被广泛用于量化数据集之间的相似性[31],并且在推广研究的过程中,该指标被考虑用于比较两个实体之间相对内性水平、连续向量空间中集合的各自扩展、量化两个随机变量之间联合相互依赖关系。并且,Jaccard系数能够有效消除度中心性较高的节点带来的偏差,从而更准确地衡量节点对之间连接的相对紧密程度[32]。此外,为了比较不同模式集问题,萨姆·弗莱彻(Sam Fletcher)也使用了Jaccard索引转换集合中的元素来度量模式集之间的相似性[33]。
与以往常用的绝对共现频次(Co-occurrence Frequency)指标相比[32,34],JBS指标具有显著优势:它通过引入并集作为分母进行归一化处理,有效平滑了因学科体量悬殊(如热门学科与冷门学科)而产生的统计噪声,避免了“马太效应”对合作强度评估的干扰。此外,相较于余弦相似度(Cosine Similarity)等基于向量空间的指标[35],JBS更侧重于集合层面的重叠比例,因此能够更敏锐地捕捉到那些规模虽小但合作紧密度极高的跨学科互动模式。
引用中位次数:为每一年中特定学科组合的所有文章被引用数量的中位数,是衡量科学影响最常用的定量指标[36-37]。由于论文引用次数分布通常具有右偏性,即少数高引用论文拉高了平均值[38],本研究在此使用引用次数中位数来更好地代表一个跨学科组合的整体影响力,避免被极端值所影响。
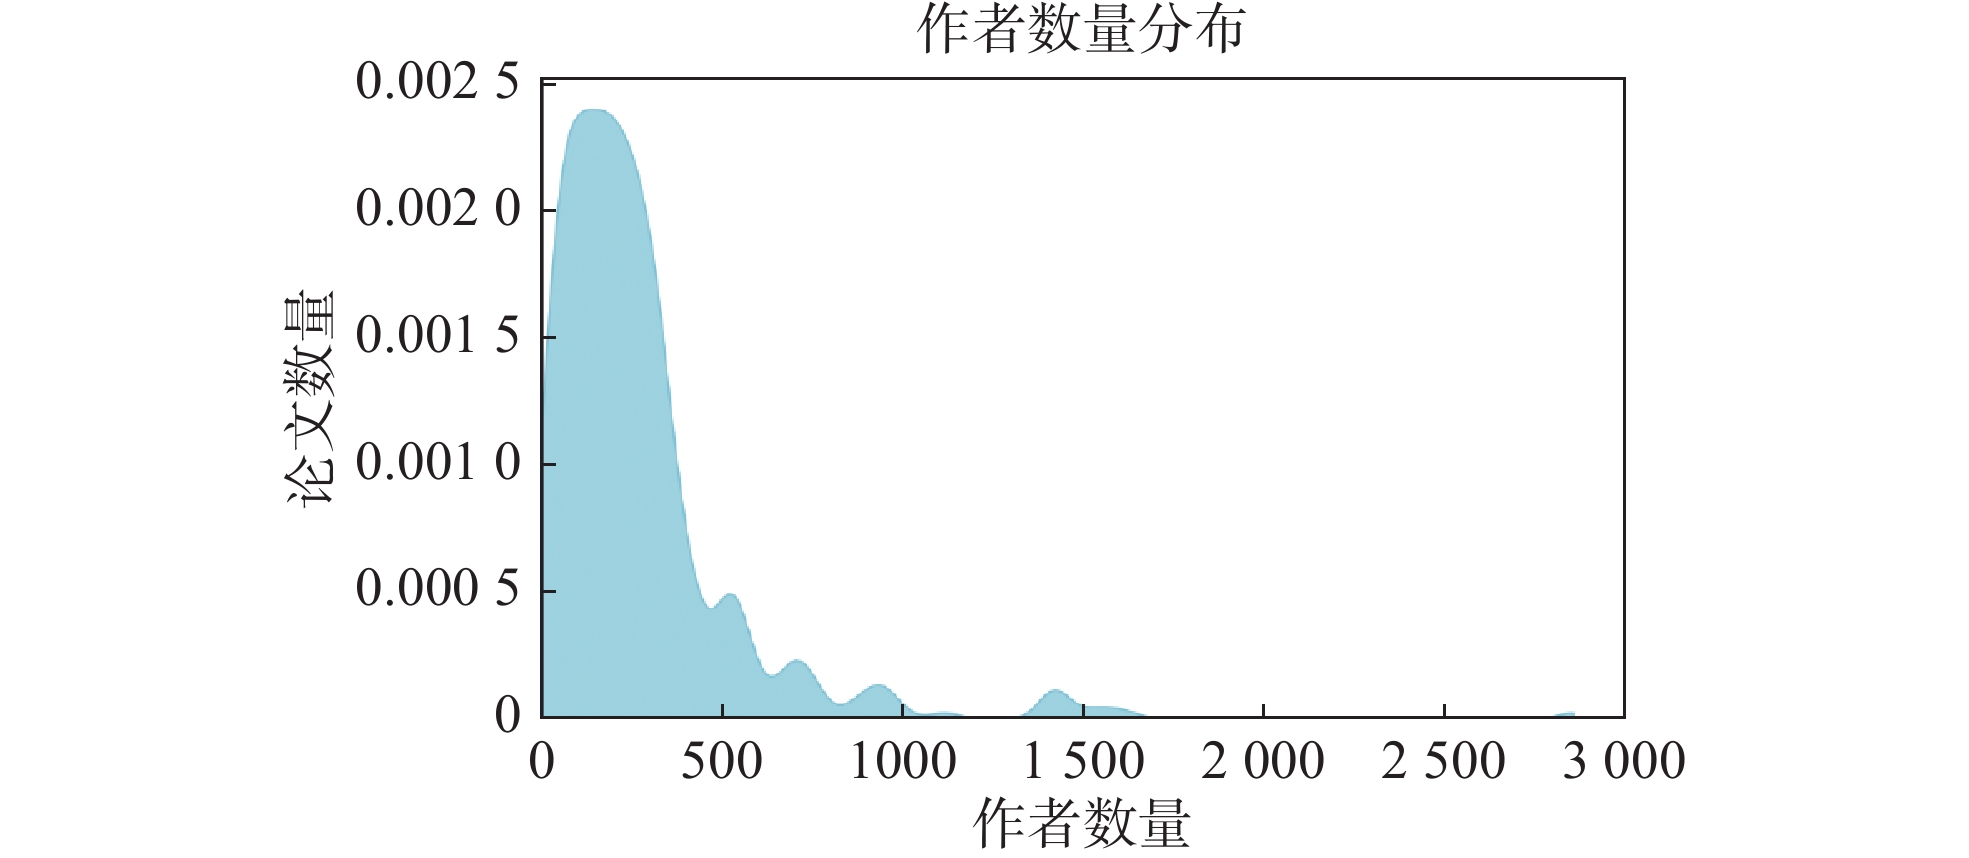
合作者中位数量:为每一年中特定学科组合的所有文章团队大小的中位数。作为团队合作的直接体现,对于理解跨学科合作的动态变化具有重要意义。斯特凡·伍赫蒂(Stefan Wuchty)等人分析了科学研究中团队合作的趋势,指出越来越多的研究成果由多作者团队共同完成[39]。可以通过作者数量反映跨学科论文的协作程度[40]。通过对比不同跨学科组合的作者数量中位数,不仅有助于量化跨学科合作团队的一般规模,避免受到极少数高度合作的论文影响,还有助于评估研究领域的整合程度[13]。同时,为了避免合作规模异质性造成的影响,我们在整体数据层面计算了合作作者数量的加权均值(2.82)、加权中位数(2.00)、方差(33.42)和标准差(5.78),结果显示,虽然存在一定程度的方差,但中位数与均值之间差距较小,大多数论文作者数量集中在2—5人之间,表明主流合作模式较为一致,分布呈现集中性。我们也绘制了作者数量的平滑分布图(详见附录2的附图2),进一步印证了以MAC指标表征典型合作规模的合理性。尽管存在极端大团队现象(最大作者数达
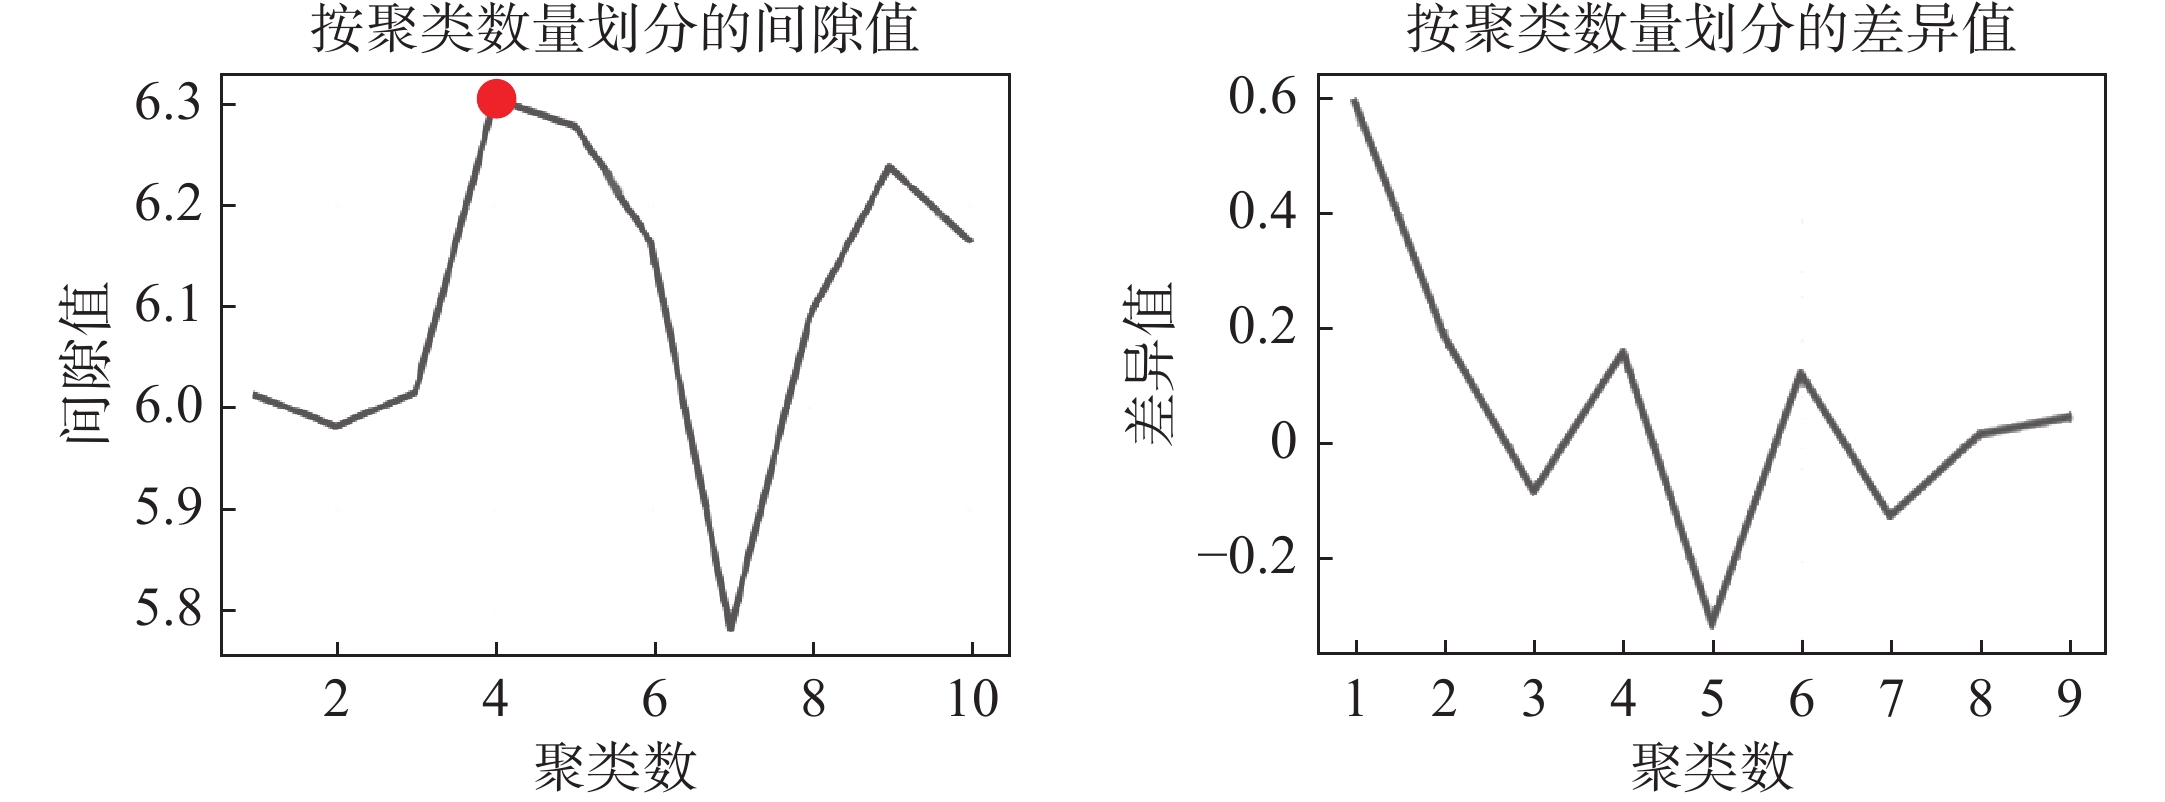
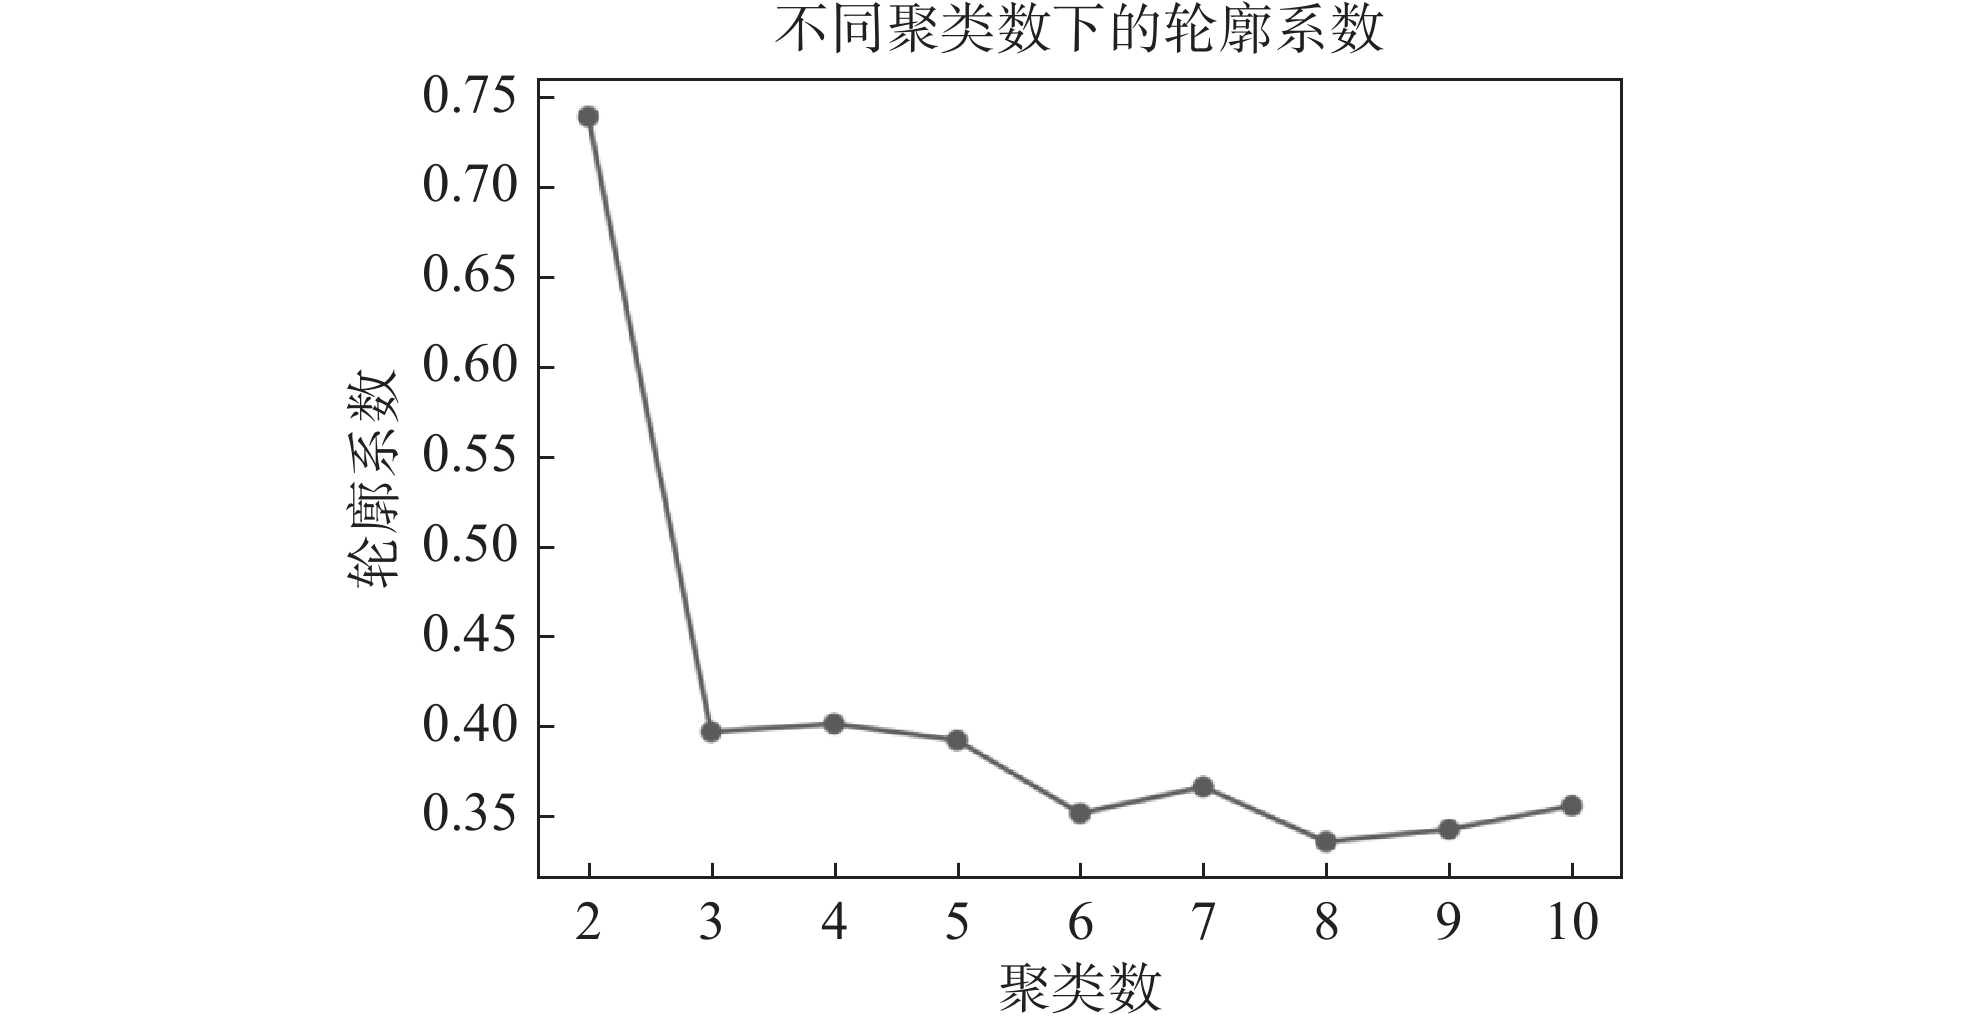
本研究使用K-means聚类方法在三维的坐标系统进行跨学科合作的模式识别[41]。K-means聚类算法作为一种经典的无监督学习方法,在处理大规模数据集方面具备较高的伸缩性与计算效率。其根据数据对象之间共享的数据的属性对数据进行聚类,它能够将大量数据点分成若干个簇(cluster),使得同一簇内的数据点相似度较高,而不同簇间的数据点相似度较低[42]。自其提出以来,在数据挖掘、图像处理、自然语言处理、生物信息学等多个领域得到了广泛应用[43-45]。在跨学科模式识别中,K-means聚类算法能够依据上述三个指标对跨学科组合进行聚类,这三个指标共同构成了跨学科合作特征的多维空间,能够更全面地捕捉不同学科组合之间的相似性和差异性,从而揭示出跨学科合作的模式及演变,还能识别出不同学科间潜在的合作机会。当两个或多个学科组合在聚类过程中展现出相似的特征或模式时,可以合理推断它们之间可能存在着共同的合作特征或机制,从而将它们归类为同一种跨学科合作模式[46]。在K值(聚类数)的选择上,我们综合采用了间隙统计量法(Gap Statistic)[47]与轮廓系数(Silhouette Coefficient)[48]进行评估(详见附录2的附图3和附图4)。结果表明,当K=4时,模型在保持较高轮廓系数的同时,各类别内部特征分布紧凑,类别间差异显著,具有更强的辨识度与实际解释力。因此,最终确定采用K=4作为K-means聚类的参数设定。
通过对聚类结果的分析,可以进一步观察到某些类别是否具有特定的学科组合特征,是否存在显著的时间变化趋势,以及这些模式如何反映不同学科之间的合作关系和演变规律,从而为理解跨学科合作模式的动态变化提供重要参考。
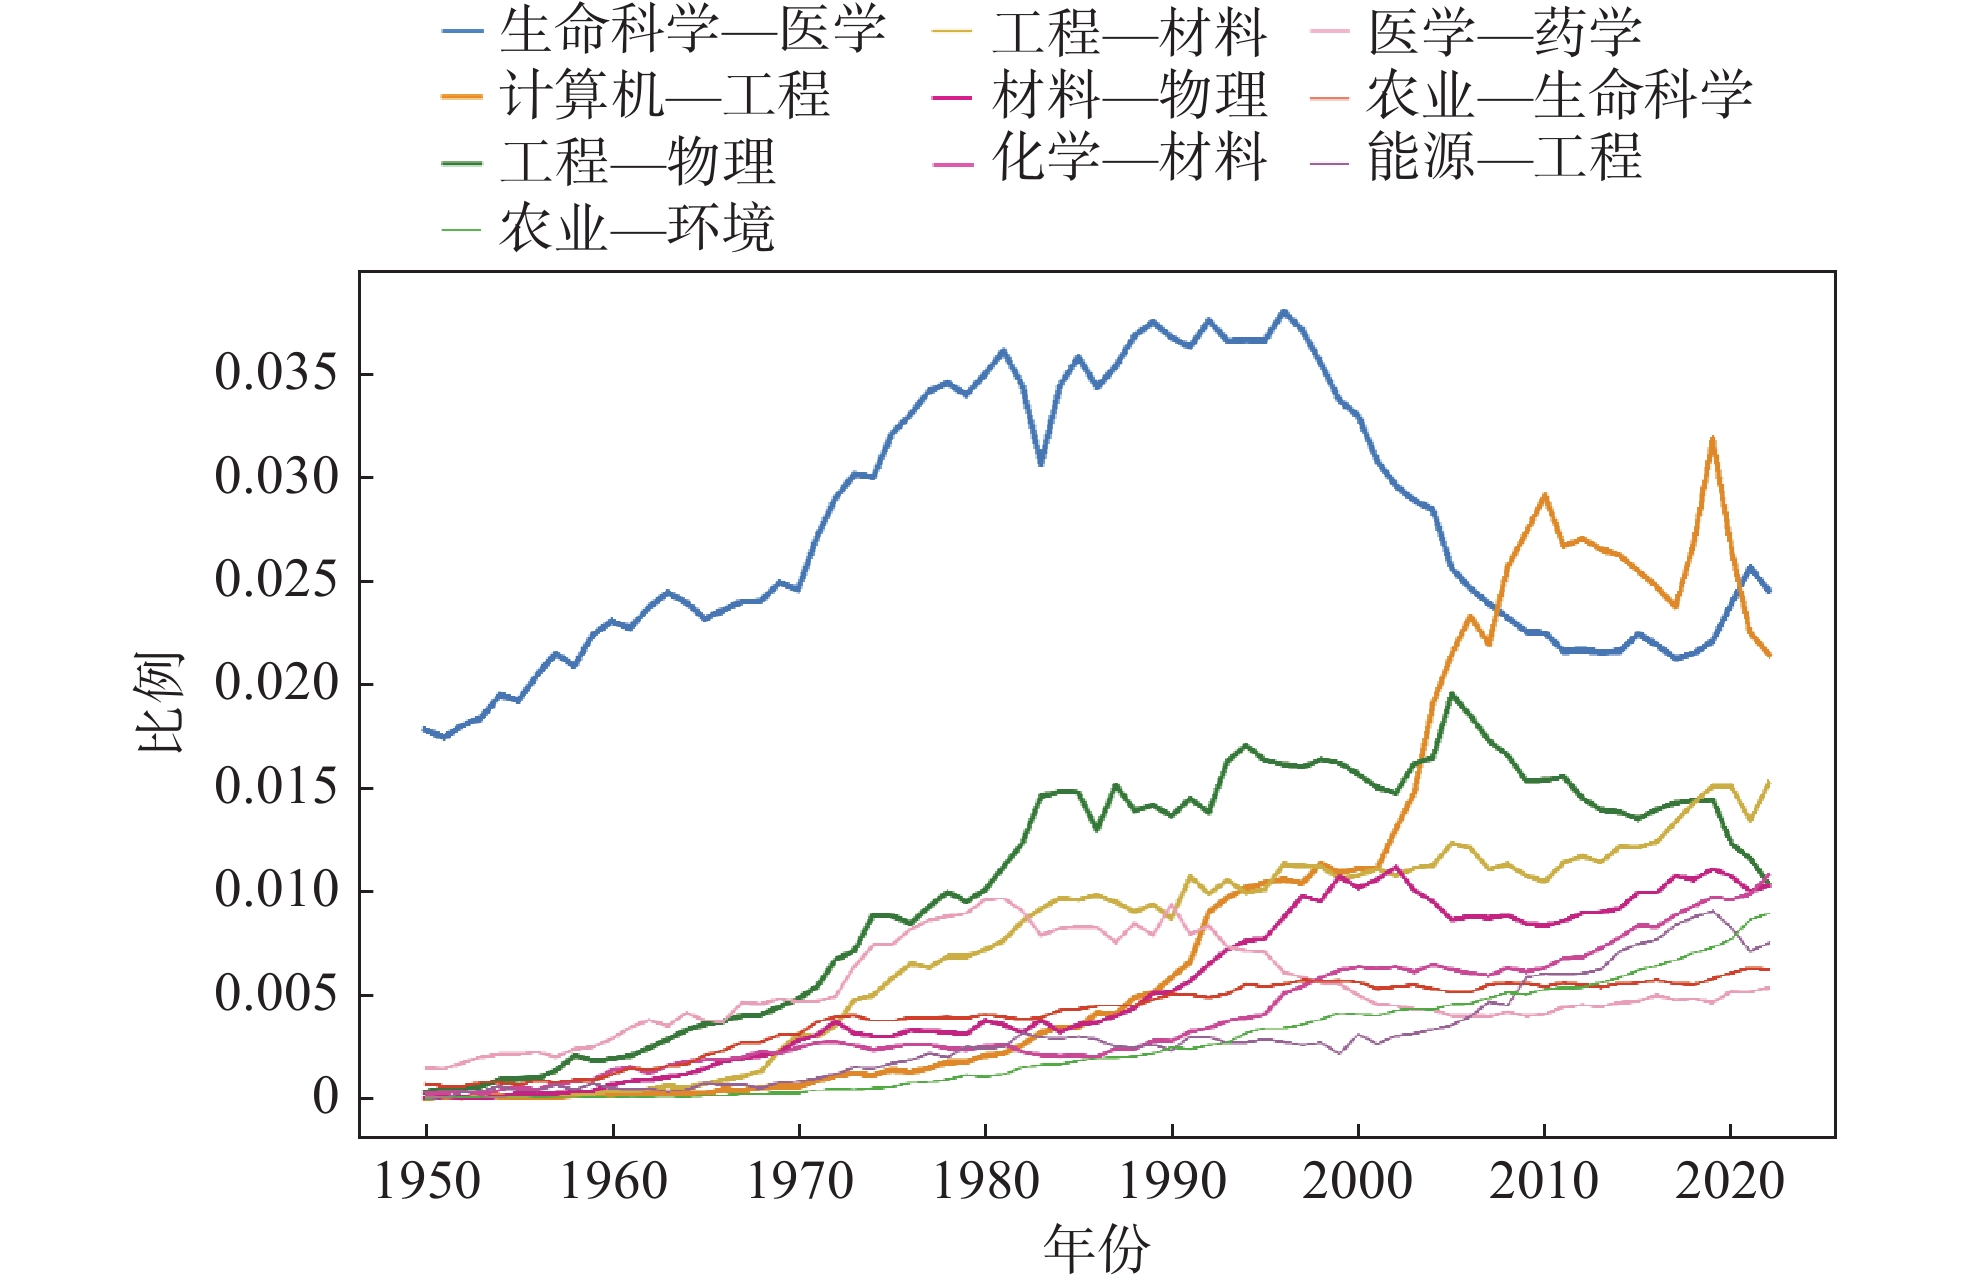
三、研究过程与结果分析 1. 跨学科合作的整体趋势本研究评估了从1950—2022年期间各学科间合作组合及相关论文发表数量和比例的变化(示例详见附录2的附表4)。可以观察到在七十多年间,“生命科学-医学”学科组合的形成及其持续领先至2010年(见图1),反映了两者之间不断增强的整体性融合趋势,并持续为科学研究领域创新突破做出了重大贡献[49]。生命科学的进展为医学提供了重要的实验技术和理论框架,既促进了对疾病机制的深入理解,也推动了新疗法的开发。与此同时,医学领域的实际需求也在不断影响生命科学的研究方向,例如,针对特定疾病的分子机制研究愈发受到重视。2010年后,随着互联网和数字技术的蓬勃发展,“计算机科学-工程科学”组合迅速崛起,并在过去十年中占据主导位置,其发表论文数量的显著增加不仅反映了其研究活动的活跃性,也彰显了丰硕的科研成果。这一学科组合的兴起促进了技术创新和工程应用,推动了多个行业的转型与升级,成为现代科技发展的重要驱动力。此外,在1960—1990年间,“医学-药学”的组合一直位列前五,但在20世纪90年代之后排名逐渐靠后。这一现象表明,面对新的研究热点与科技进步,某些传统的跨学科合作或面临着重大的转型挑战。相比之下,“工程科学-物理学”的组合自20世纪80年代以来稳定位于前列,显示出这两个学科之间存在深厚的创新合作基础。而“工程科学-材料科学”组合,自1980年起稳居第四,并在2020年升至第三位,表明材料科学与工程技术之间的紧密融合正在不断加深。
|
图 1 跨学科组合的论文数量占比变化趋势(前10) |
从整体上看,跨学科合作的规模持续增长,领域已从生命科学与医学等传统相关学科,逐渐扩展到计算机科学、环境科学和社会科学等领域,形成了多学科交叉的研究格局。这一趋势不仅反映了学科知识边界的扩展,还表明科研资金和关注焦点正逐渐向这些领域倾斜。与新兴交叉学科相比,传统的跨学科合作领域,如医学与药学,在适应信息化于数字化转型时面临挑战,亟需重塑研究策略,以应对不断变化的外部环境。
2. 基于 JBS、MCC、MAC指标的跨学科合作分析(1)JBS指标分析
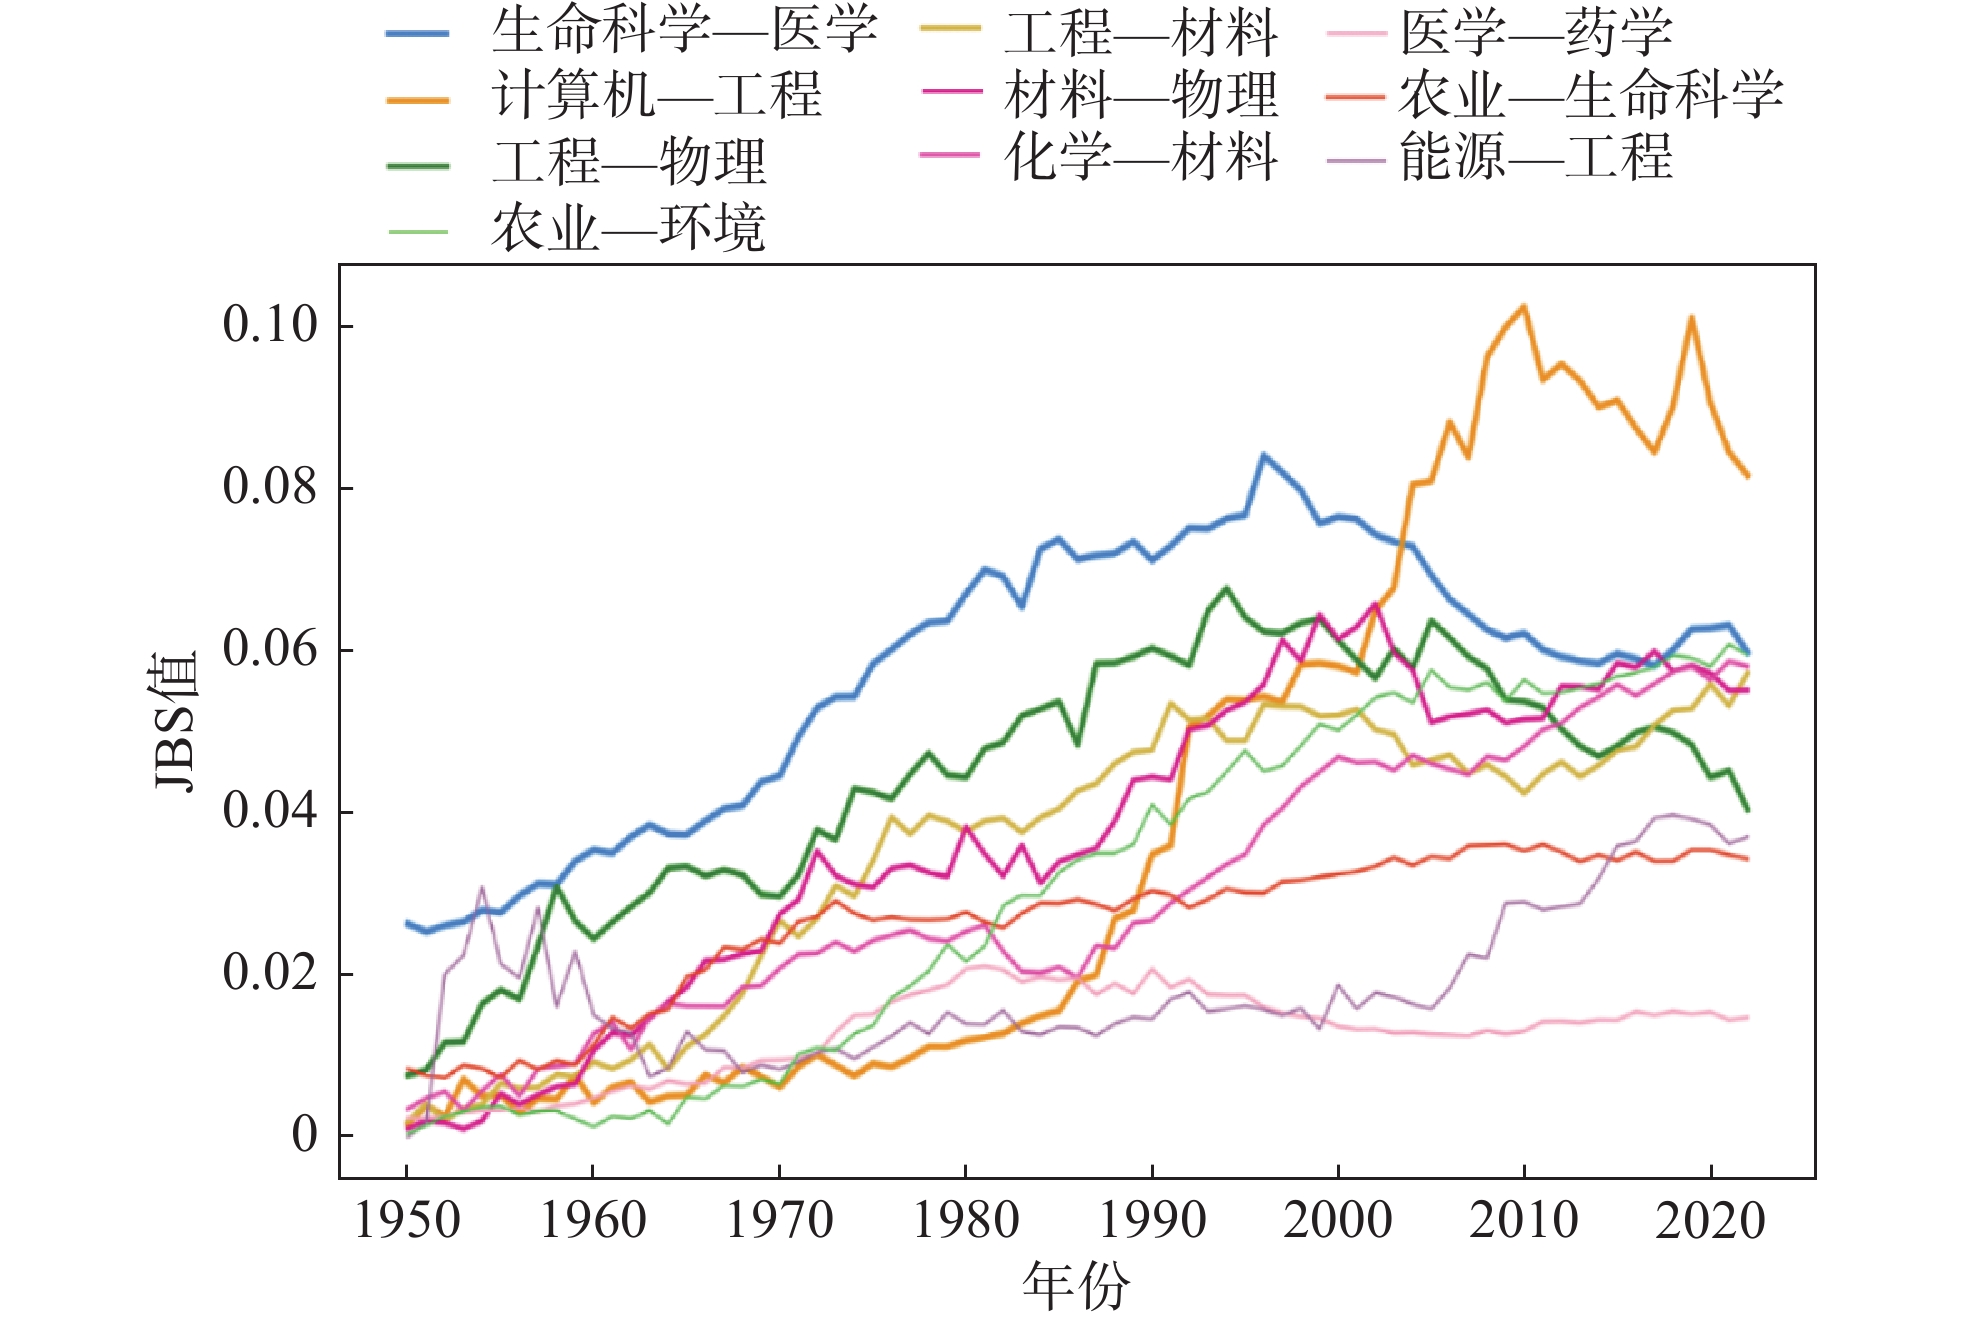
跨学科合作强度在不同历史阶段具有显著变化,总体呈现紧密化趋势(见图2,示例详见附录2的附表5)。1950—1980年,JBS值较高的学科组合主要集中在传统领域,例如“生命科学-医学”“化学-工程科学”和“数学-物理学”。其中,在1950—1960年间,“化学-化学工程”是最为密切的跨学科合作组合(JBS值为0.07与0.05),但随后呈现出持续下降趋势。而1970—1990年期间,“生命科学-医学”成为最主流的跨学科组合(JBS值依次为0.06、0.07与0.08)。表明早期阶段,跨学科合作多发生在具有高度关联性的领域,合作基础较为牢固。
|
图 2 发表数量前十的跨学科组合JBS指标变化趋势 |
1980年后,新兴领域的跨学科合作迅速崛起,尤其是“计算机科学-工程科学”“农学-环境科学”和“化学-数学”等领域的JBS值显著上升。对于“计算机科学-工程科学”组合而言,在1990年前,该组合的JBS得分虽然较低(JBS值低于0.02),但持续呈上升趋势。特别是在1990年左右,其增长速度显著加快。而进入21世纪,该组合的跨学科合作成为了跨学科组合的常见范式,并在2010年左右达到顶峰(JBS值超过0.10)。从跨学科组合的JBS指标变化来看,不仅体现了跨学科领域技术与方法融合的必要性,更反映出全球科学研究围绕重大挑战(如高性能计算技术的突破、自动化与智能制造的发展、以及复杂系统的优化与建模)而加速向跨学科合作模式演进的总体趋势,与科学问题复杂性日益增加和全球性议题驱动形成了呼应。
此外,从学科间的配对组合看,从1950年开始,跨学科的合作组合逐步形成了特定组合集群,包括以生命科学、医学为中心的医疗与健康组合集群,以数学、计算机科学、工程科学为中心的科学工程集群,以及以经济学为中心的社会科学组合集群。随着知识的深入以及专业壁垒的加强,跨学科合作模式受学科属性(如研究议题、研究范式)的影响更为凸显。继而,学科属性类似(如议题相对亲近、研究范式相对一致)的学科更容易形成聚集性的合作聚落;而学科属性差距较大(议题相对区隔、研究范式不太一致)的学科间的合作张力增强。
(2)MCC指标分析
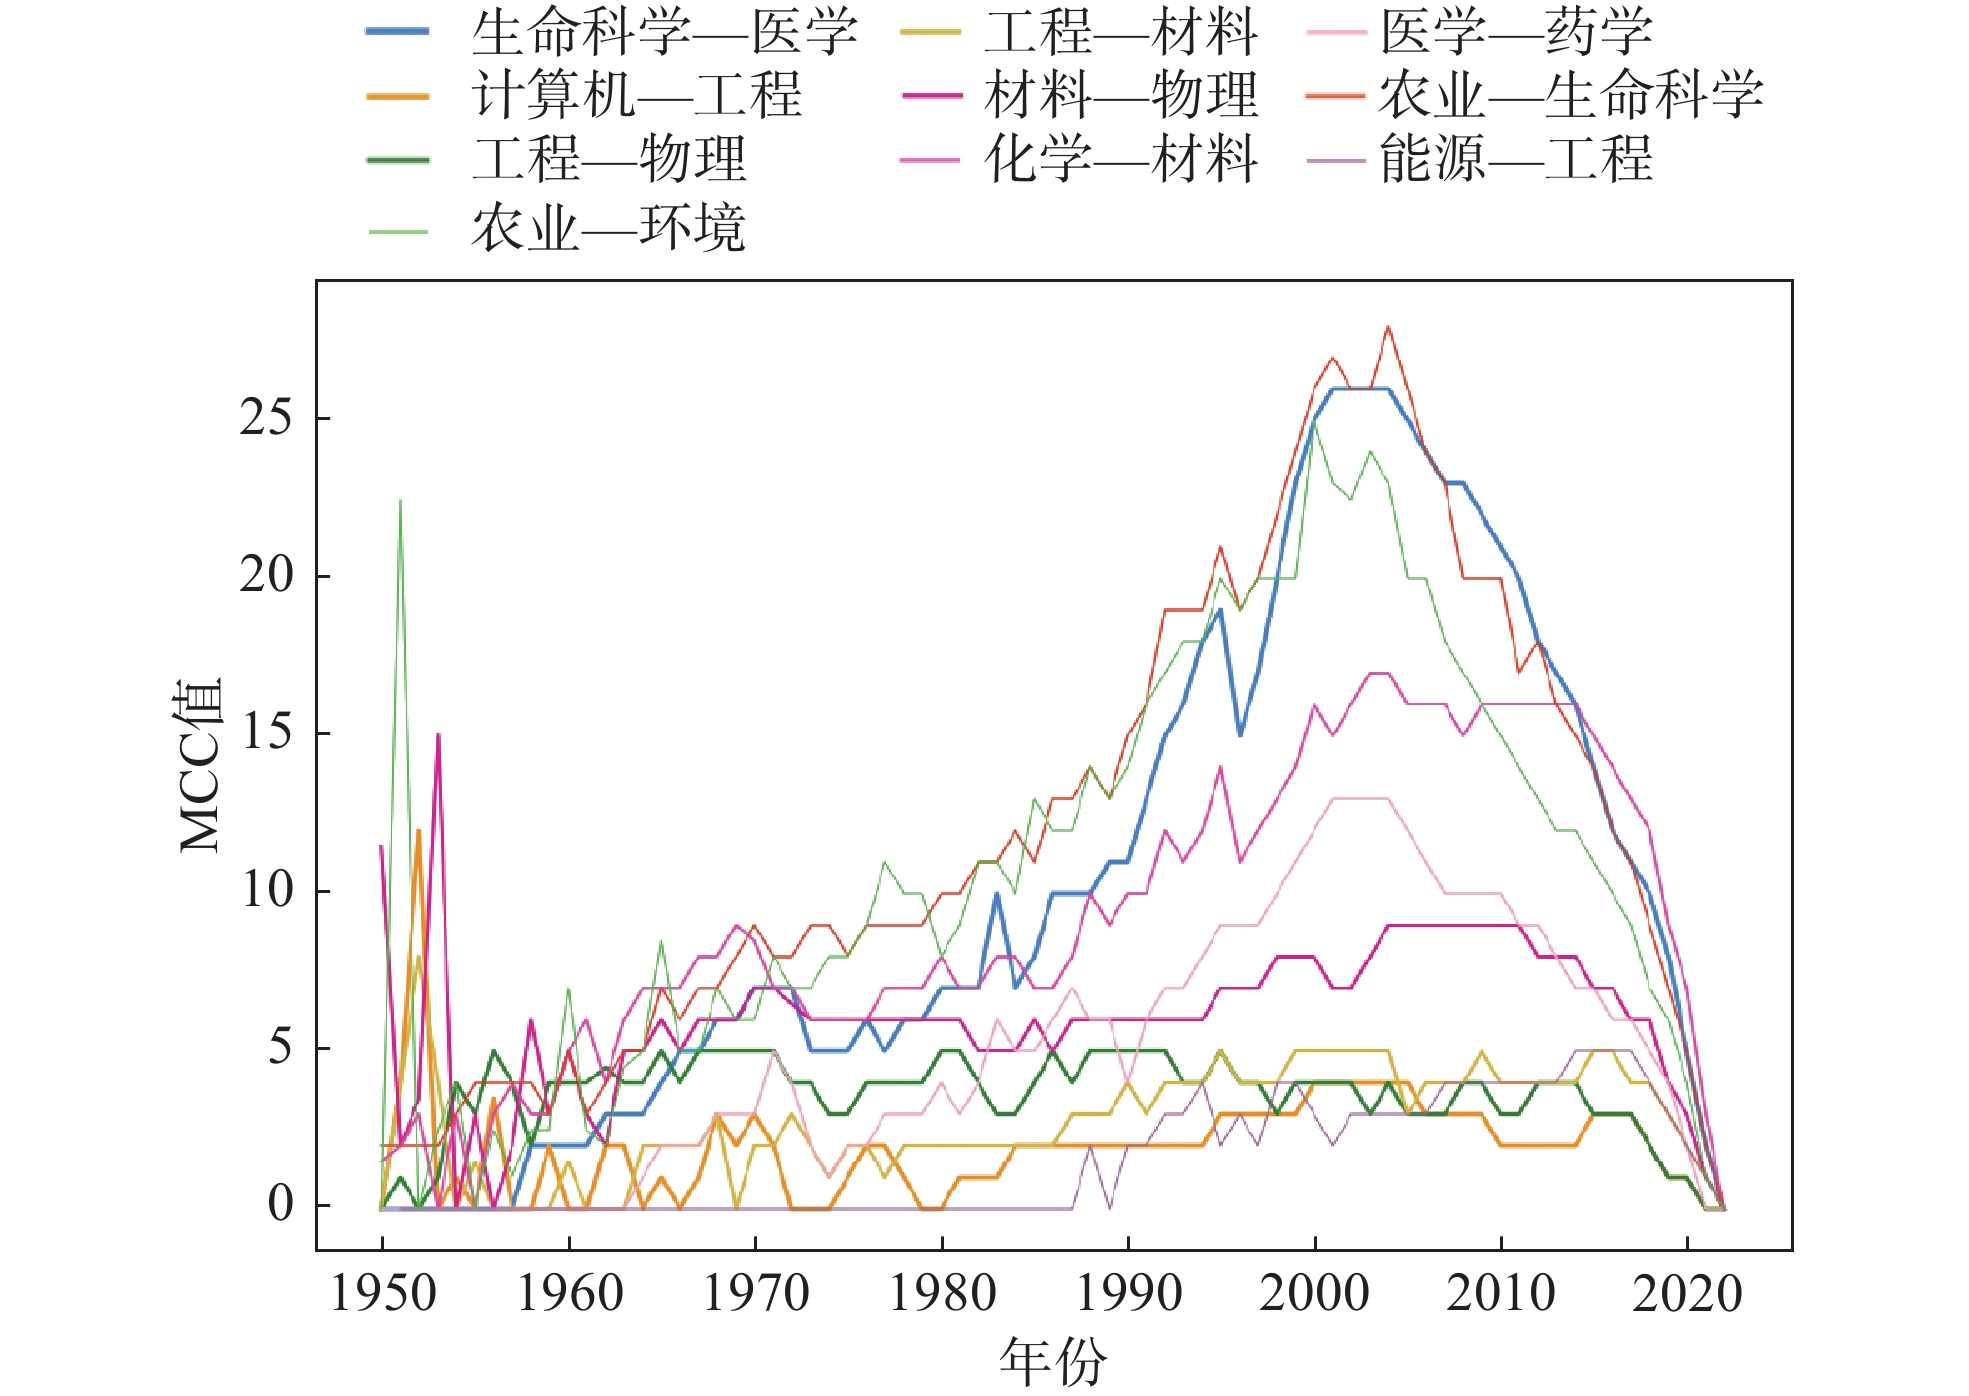
跨学科合作影响力呈现扩大化趋势(见图3,示例详见附录2的附表6)。
|
图 3 发表数量前十的跨学科组合MCC指标变化趋势 |
在1950—2000年间,不同跨学科组合的MCC值呈现出持续上升的趋势,MCC值较高的领域集中在“生命科学-医学”“生命科学-农学”和“农学-环境科学”等,这些领域的高引用率源于其研究内容对科学前沿和社会应用的双重推动(如生命健康、可持续发展等),应对前沿复杂科学问题的有效性和先进性。2000年以后,各学科组合的MCC值普遍回落,并非完全意味着跨学科合作影响力的减弱,部分下降趋势可能受到论文引用数量随时间的积累效应影响——新发表的论文需要时间来积累引用数,同时科学出版物的不断增长和引用趋势的变化也可能影响MCC的长期趋势。
(3)MAC指标分析
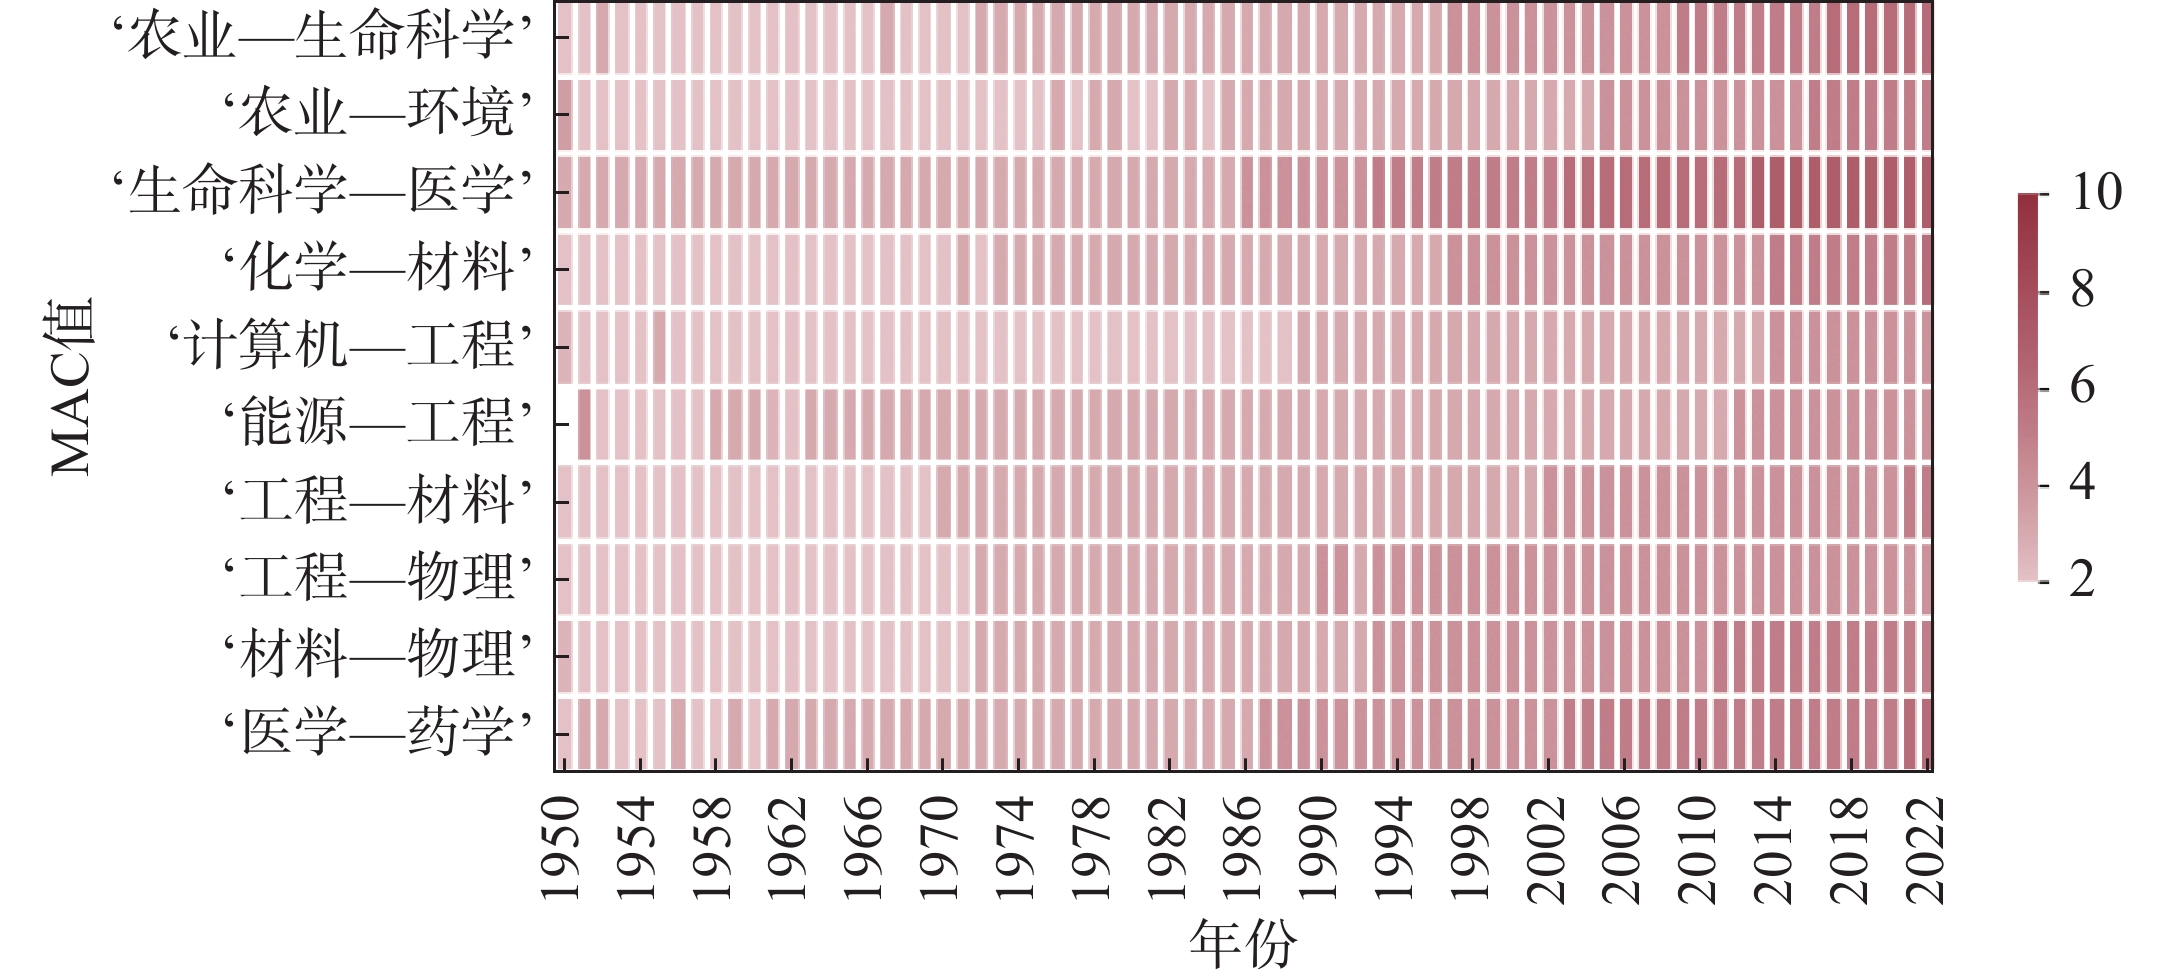
跨学科合作团队正逐步呈现规模化趋势(见图4,示例详见附录2的附表7),随着时间的推移,跨学科研究的团队规模呈现出持续扩大的趋势,但不同领域之间的增速和规模差异较为明显。
|
图 4 发表数量前十的跨学科组合MAC指标统计图 |
其中,“生命科学-医学”领域的增长最为明显,团队规模自1985年后迅速增长,中位作者数量从20世纪末的约4人增加到2020年的10人,这来源于基因组学、蛋白质组学等复杂科研领域对多学科协作的高度需求。例如,人类基因组计划的推进涉及全球多个实验室和数百位科学家的协作。相比之下,一些社会科学领域的交叉合作团队规模增长相对缓慢,例如,“社会科学-计算机科学”领域中位作者数量在过去70年间从约3人仅增长到5人左右。
这种领域差异也反映了研究复杂性和资源需求的不同特点。大规模团队(如超过10人)更适配自然科学和工程学科,这些领域通常需要大型实验设备和多学科大工程协作能力。而小规模团队(如少于5人)则多见于社会科学和人文学科,更利于保障研究灵活性和集中性,适配复杂社会现象或特定文化背景的个性化和深度化研究。
总的来说,JBS、MCC、MAC指标共同揭示了跨学科合作“关系紧密化、影响力扩大化、团队规模化”的核心趋势,表明跨学科合作已不再是某个小领域的研究特色或局部问题的解决方案,而是成为了科学研究中的“新常态”。
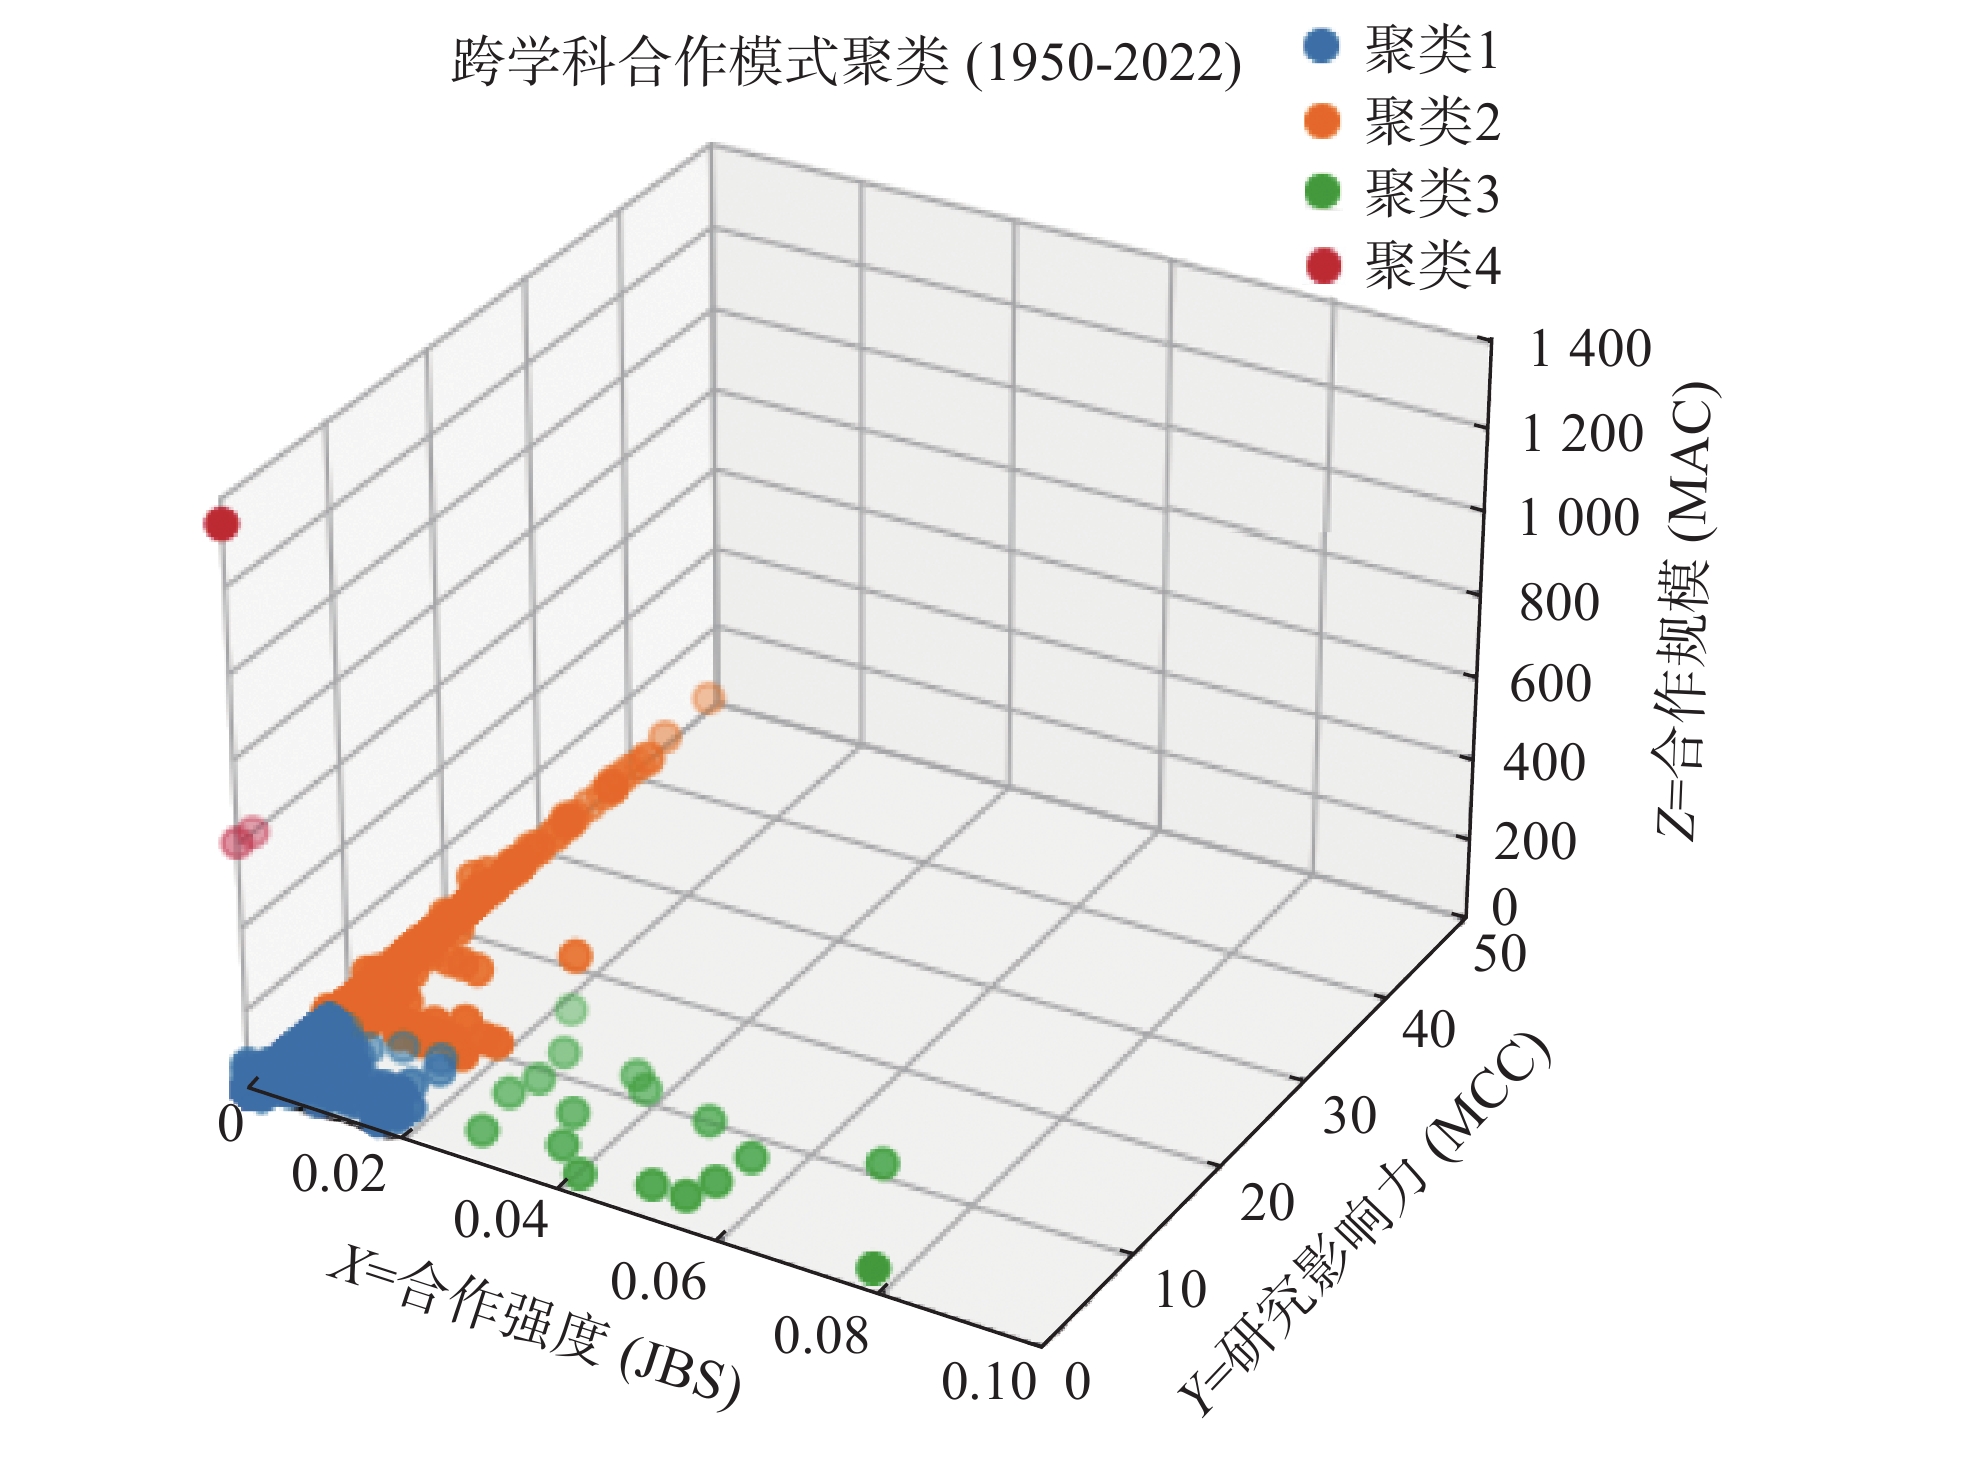
3. 跨学科合作的模式识别与涌现不同跨学科组合在JBS、MCC、MAC等指标上的表现差异也暗含了跨学科合作组合间的内在异质性。这种异质性不仅反映了跨学科合作的多样性,也揭示了其背后潜在的多样化合作模式。基于上述考虑,本研究采用K-means聚类分析方法对跨学科合作组合进行系统划分(见图5)。重点关注合作强度、研究影响力与合作规模等关键因素之间的耦合效应,并据此归纳出跨学科合作关系的典型特征组合,进而揭示不同合作类型在组织机制、资源需求、协作路径等方面的结构性差异,为后续探索跨学科合作的演进路径提供了分析基础。
|
图 5 跨学科合作模式识别 |
从分析结果来看 ,本研究主要识别出下列四种跨学科合作模式(见图6) :

|
图 6 四种类型跨学科合作示意图 |
兴趣导向型(Emerging and Hot Topics):这一类型模式的JBS介于0至0.02之间,表明研究团队成员可能来自多个不同的学科背景;MCC在0至7.5之间,研究影响力相对有限,MAC在2至68.5之间,合作团队规模较小至中等。这类合作围绕新兴领域和热点话题形成的,具有随机性和自发性,倾向于快速响应科学前沿领域的发展,如半导体物理学、电子学以及量子计算领域的研究,往往被看做观测前沿技术进步动态的重要标志。
层级结构型(Structured Hierarchy):层级结构型模式通常由具有深厚历史背景的学科发展而来,展现出明显的组织化层级结构。这些研究团队的JBS指标与兴趣导向型相似,MAC指标略高,范围在3—70之间,最为显著的区别在MCC指标,范围在7.5—50之间,明显高于其他类型,体现出强大的研究影响力。这类合作通常由个人研究兴趣逐步演化,形成具有稳定层级结构的学术派系与专业领域,在整个跨学科合作中占据了较大的比例。其典型领域包括分子生物学、基因工程以及再生医学等,依赖长期稳定的研究投入和严密的合作结构,以支撑其复杂和持续的研究任务,并体现出强大的演进影响力和协同效应。
亲缘关系型(Relative Close Discipline):该类型的特征在于其成员通常来自于学术关联紧密的学科。这些研究团队在JBS指标上体现为0.02到0.08的数值,合作强度较强。MCC指标通常介于2—16之间,具有一定的影响力。MAC指标保持在3—5之间,反映出合作规模适中,既不小到限制研究深度,也不大到降低团队沟通效率。这类跨学科合作的数量相对较少,分布较为松散,常见于“经济学-管理学”“计算机科学-数学”以及“心理学-社会科学”等领域。这些领域有着相似的研究方法论或共同的研究目标,促进了学科间的协同合作。
资源密集型(Large Project):该类型团队的JBS指标较低,通常不超过0.01。MCC指标的区间在1—1.5之间,研究影响力较为有限。最为显著的是MAC指标,其数值范围从60.5到
通过观测不同时间段的跨学科合作模式,可以发现跨学科合作模式的演变主要经历了三个阶段(见图7)。

|
图 7 资源密集型跨学科合作模式的出现 |
1950—1980年,除了在冷战背景下,以军需和国防科技为主导的科学研究以外,大部分跨学科合作以兴趣导向型合作为主,其特征是研究团队规模较小、合作强度较低,更多地依赖于学者们基于领域前沿与社会问题自发性开展跨学科合作。例如,美国的城市规划师与社会学家合作,研究城市贫困、住房问题和交通拥堵等城市病,提出了许多创新的城市规划理念。
1980—2010年,层级结构型合作的增长显著加速,成为这一阶段跨学科合作的重要模式之一。随着各国重大科研政策、科研计划与项目指南的发布,科研项目规模快速扩大和重大问题研究需求急剧增加,高度的组织化和结构化特征的跨学科合作模式成为主流。同时,兴趣导向型(如数学、物理学等交叉研究)和亲缘关系型(如经济学、管理学等交叉研究)合作模式也在同步增长。
2010年后,科技创新成为各国核心战略,资源密集型跨学科合作模式快速涌现,大科学有组织的跨学科合作范式成为了解决某些前沿复杂重大科学问题的重要形式,同时也对当前科研体制中的基金资助、人才管理以及组织结构优化和效率提升提出了新的挑战。
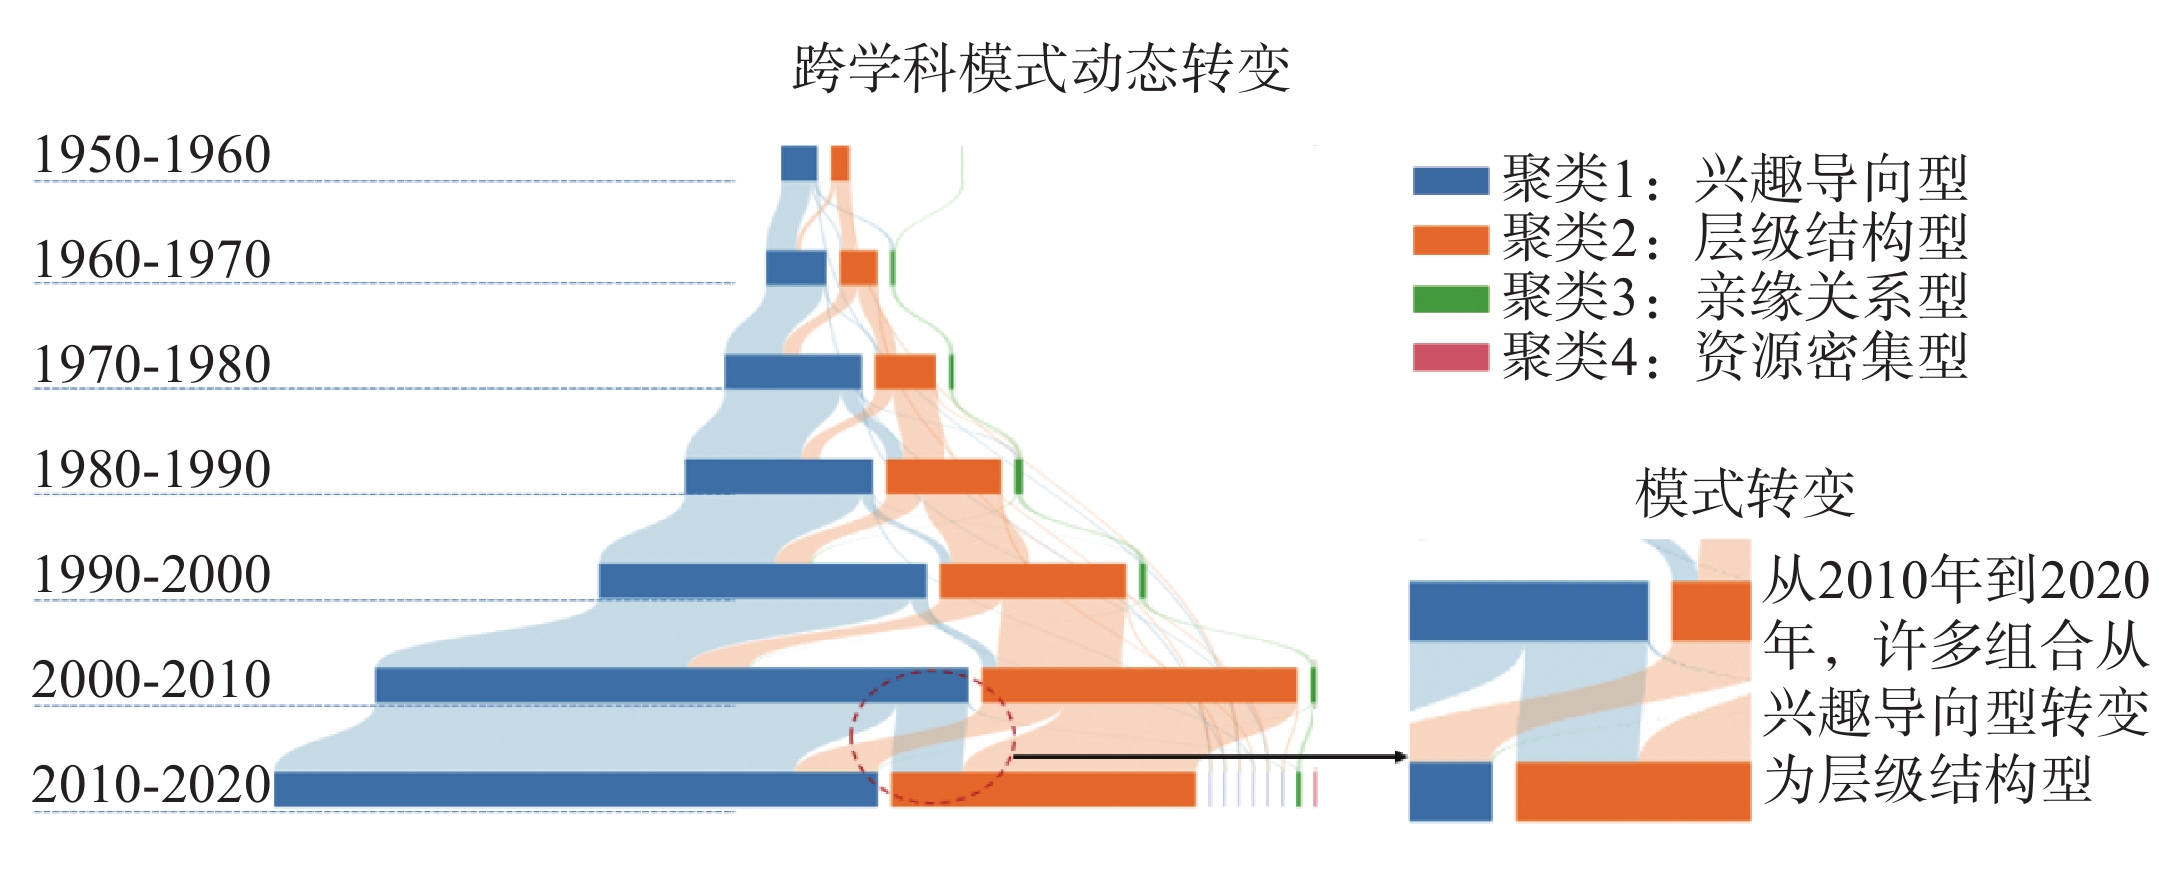
值得注意的是,在2010—2020年期间层级结构型合作显著增长,逐步取代了早期较为松散的兴趣导向型合作。跨学科合作模式逐渐从兴趣导向型(emerging)转为层级结构型(structured),反映出合作组织方式正在走向制度化与体系化(见图8)。
|
图 8 “兴趣导向型——层级结构型”的跨学科模式转变 |
以“人类细胞图谱”计划(Human Cell Atlas, HCA)为例,该项目于2016年由Broad Institute 的阿维夫·列格夫(Aviv Regev)与Wellcome Sanger Institute的萨拉·泰希曼(Sarah Teichmann)联合发起,初期围绕单细胞测序(single-cell RNA-seq)等新兴技术形成。据 El País 报道[50],HCA启动时,由约100位发起科学家组成初期规划团队,随后约有500名来自19家机构的研究人员加入探索性工作,涵盖生物信息学、免疫学、分子生物学等多个学科领域,合作结构相对松散,属于小规模兴趣导向团体,也突显其兴趣驱动和探索性特征。2018年前后,HCA扩展为覆盖全球75个研究机构、
“地球微生物组”计划(Earth Microbiome Project, EMP)[51]的演进路径同样印证这一趋势:2010年由美国芝加哥大学、阿贡国家实验室、加州大学圣地亚哥分校等机构联合发起,初期目标是整合全球环境样本中的微生物多样性信息,探索微生物生态的基础规律。项目早期(2010—2012年)主要依靠自愿参与的兴趣导向型合作机制,约由10余家实验室协作进行样本采集与16S rRNA测序,合作结构较为松散。随着项目影响力上升,EMP逐步进入组织化扩展阶段(2013—2016年)。在此阶段中,项目确立了统一的数据提交标准(如EMP标准化协议)、分析流程(如QIIME 平台)、数据库系统(如Qiita)[52],并获得包括Templeton基金会、WM Keck基金会在内的多方资助,参与团队迅速增长至超过160家机构、500余位科学家,开始形成围绕采样、建库、数据处理、环境关联分析等环节的分工团队。到第三阶段(2017年以后),EMP演化为典型的“层级结构型合作”模式。项目正式划分出多个子模块与功能组(如EMP500、meta-analysis小组、计算平台组等),推动数据与协议的标准化协同,主导者则通过设立“协调中心”统一发布版本迭代、发布流程说明文档,确保全球不同实验室可在相同框架内运行与复现。到2020年,EMP共整合超20万个样本、生成2.2亿条序列数据,成为全球最大环境微生物数据集之一,其合作结构展现出清晰的多层次组织逻辑、标准化管理机制与任务分工体系,实现了“兴趣导向→探索性集成→平台化制度合作”的完整演进。
上述案例表明,跨学科科研合作正经历显著转型。在技术复杂性不断提升、科研资源持续集中以及全球性科研组织压力增强的多重驱动下,合作模式正从早期的“兴趣导向型、小规模、自组织”逐步演化为“大科学背景下、任务导向、制度化”的层级结构型合作范式。这一范式演化呈现三大趋势:①合作结构的制度化:明确分工、建立协调中心、实施统一数据发布机制;②资源整合的集中化:依托大型基金会或国家计划进行统一资金配置与平台支持;③研究流程的标准化:从实验范式到数据分析流程高度统一,提升跨团队间的数据复现性与协同效率。
研究认为,这一转变的原因主要有两方面:首先,随着跨学科知识体系的扩展与发展,跨学科合作愈加依赖专业化技术和大规模数据平台。尤其是在神经科学、基因组学和生态微生物等前沿领域,大量高精尖设备(如单细胞测序仪、Neuropixels电极)和算法平台的投入成为必需,这使得自发、灵活的小型合作已难以支撑前沿问题的深入推进,科研组织因而倾向转向结构清晰、协作高效制度型团队合作模式。其次,在“产出导向”成为科研评价主流的背景下,科研资金分配机制日益倾向支持目标清晰、团队稳定、产出可量化的大型合作项目。这进一步强化了层级化团队的主导地位,并加快了合作机制的制度化进程。此外,兴趣导向型是新兴学科的重要源头,许多层级机构型项目起源于兴趣驱动、理念探索与方法共享。因此,对于处于这种从“探索性合作”向“结构化合作”转型过程中的项目,应提供足够的政策空间与资源保障,确保其在保持学术自由的同时,能持续向更高水平的协同研究迈进。
四、研究结论、挑战与对策 1. 研究结论本研究基于1950—2022年间的
进一步地,不同学科组合的合作模式与演进趋势展现出显著差异性与演进趋势。从领域动态变化来看,医学与生命科学在跨学科合作中长期处于核心地位,而自21世纪初以来,计算机科学与工程科学的合作影响力迅速增强,逐步跃升至跨学科合作中的核心位置。此外,工程科学与物理学、工程科学与材料科学以及数学与物理学等领域的合作一直表现出较高的稳定性和活跃度。这些领域动态的变化与技术快速迭代、科研需求升级及社会问题复杂化密切相关,反映了不同跨学科组合在应对新时代科技与社会挑战中的协同作用。
在此基础上,本研究进一步对当前领域进行了研究拓展。首先,研究识别出兴趣导向型、层级结构型、亲缘关系型和资源密集型四种主要跨学科合作模式。特别是资源密集型模式自2010年后快速涌现,标志着跨学科合作逐渐向有组织的大科学研究方向发展。其次,揭示了跨学科合作模式的演变特征,正在呈现出从兴趣导向型向层级结构型演变的趋势,反映出科研活动对政策支持、科研资助与组织优化的需求日益增长。最后,研究表明,跨学科合作通过整合不同学科的视角和方法,显著拓宽了科学研究的广度和深度,不仅推动了前沿科学问题的突破,还促进了技术创新与应用转化,在精准医疗、智能制造、可持续发展等领域展现出巨大潜力。
需要指出的是,本研究基于已发表的科学论文数据开展分析,因此可能存在一定的发表偏差,即未涵盖未能发表的跨学科合作案例。因而本文实质上研究的是跨学科合作发表的特征与演化规律。未来研究可进一步结合科研项目数据、失败案例或灰色文献,以更全面地揭示跨学科合作的全貌。
2. 挑战与建议尽管跨学科合作具有巨大的潜力,但其发展仍面临一系列深层次的挑战,具体包括以下几方面:
学科间范式差异所引发的协作张力显著加剧。MAC与JBS指标的分析显示,不同学科领域在合作模式上呈现出多样化特征。例如,工程科学、生物医药等领域中,部分研究项目倾向于依赖资源密集型与大规模团队协作,而社会科学、哲学等学科则更常见灵活的小团队合作模式。这种组织形式与知识话语体系上的差异,可能导致跨学科项目在推进过程中出现认知偏差与沟通障碍,从而影响团队协同效率及知识整合的深度与成效[53]。
跨学科合作成果的影响力增长面临瓶颈。尽管早期MCC指标呈现增长趋势,但2000年以后整体回落。这虽与引用积累的滞后性有关,但也在一定程度上反映出在学术出版数量迅速膨胀、研究关注日益分散的背景下,跨学科合作成果的显性影响力与可识别性减弱,亟需建立更适配的传播机制与认定体系[54]。
合作结构日益复杂化对组织能力提出更高要求。研究显示,在2010—2020年期间层级结构型合作显著增长,逐步取代早期较为松散的兴趣导向型合作。这类合作通常依赖大规模平台、复杂的分工体系与精密的组织协同,对科研团队的管理能力、流程标准化与数据共享机制均提出更高要求。若缺乏高效的组织设计与资源调度能力,可能导致沟通成本上升、任务执行效率降低,甚至出现资源错配与重复建设的问题。
资源门槛效应制约跨学科合作多元化发展。2010年后资源密集型跨学科合作模式的快速涌现,标志着跨学科合作逐渐向有组织的大科学研究方向发展。而这类合作高度依赖大型科研设施和大科研团队开展长周期的大规模研究,而这些资源通常集中在顶级研究机构与发达地区,中小机构或边缘团队则可能面临工具获取难、技术门槛高、参与机会有限的问题。这种“门槛效应”可能加剧科研资源在不同机构间的不平衡,限制了跨学科合作的多元性与包容性。
兴趣导向合作式微对创新活力的潜在抑制。制度化组织架构虽提高了协作效率与产出可控性,但也可能在一定程度上抑制早期研究阶段的灵活性与多样性探索,降低对颠覆性创新的包容度与孕育能力。如何在制度化治理与自由探索之间取得平衡,成为当前跨学科合作机制设计亟需应对的重要议题。
针对上述挑战,建议从制度建设、人才培养与协同机制等多个层面共同发力。
为有效缓解跨学科合作中因范式差异所引发的协作张力,首先可构建跨学科合作的中介协调机制,例如设立具备多学科背景的项目协调人,强化团队对异质学科范式的理解与组织适配能力,从而降低认知错位与沟通障碍。进一步地,应将跨学科素养系统性融入研究生教育与科研人才培养中,通过开设如“跨学科方法论”“跨领域协作实践”等课程,增强科研人员在范式转换、知识整合与跨界协作中的能力。与此同时,建议国家科研平台和重大专项支持开发面向多学科协作的标准化数据接口、知识共享平台和协作工具,增强不同范式团队间的流程兼容性与成果协同能力。
针对跨学科合作成果的影响力增长瓶颈,首先应着力构建专门的认定体系,明确跨学科研究的评估标准与成果价值,避免其在传统学术评价框架中被忽视或边缘化。为了进一步强化跨学科成果的可识别性,可以在国家科研平台与学术机构层面推动设置跨学科合作项目的专项奖项或专项基金,鼓励多学科背景团队的协同参与与产出,提升其在学术界的认可度与影响力。此外,可以加强跨学科合作成果的推广渠道,尤其是在核心学术期刊和国际会议中提高其曝光度与认知度,可以有效提升其显性影响力。
为了应对合作结构日益复杂化对组织能力提出的挑战,建议以研究项目为纽带,搭建跨学科协同平台和产学研合作联盟,推动长期、稳定的战略合作关系,强化科学导向的人才组织机制。同时,应深化人才评价体系改革,打破学科壁垒,建立科研成果互认机制和人员跨学科流动机制,优化资源配置与沟通机制,提升科研合作效率与产出质量。
针对资源门槛效应对跨学科合作多元化发展的制约,建议通过完善科研资源开放共享机制,推动大型科研设施向更多中小机构和区域性研究团队有序开放,扩大资源配置的覆盖面与可及性。依托国家级科研平台或区域协同创新中心,设立面向跨学科研究的专项支持计划,为资源相对薄弱的团队提供必要的工具支撑、技术服务与协作机会,同时,推动多层级协作机制建设,鼓励顶级机构与中小单位建立联合研究机制或子课题协同模式,实现资源由“集中式占有”向“网络化共享”的转变,增强跨学科合作的包容性与多样性,激发更多基层单位和边缘学科的创新潜力,推动科研生态整体优化。
为维护科研生态的多样性与灵活性,建议在当前跨学科合作体系中保留并强化兴趣导向型探索的空间。例如设立兼顾深耕研究与自由探索的科研项目体系。一方面支持科研人员在主攻方向上持续积累与突破,另一方面为探索性强、路径不明的研究提供制度外的空间保障,鼓励其在“无人区”开展高风险、高潜力的前沿探索。通过为不同学科背景的青年科学家提供科研资源配套与自主的技术路线决策权,激发其原始创新活力,推动研究方向的多样化与问题提出方式的多元化。同时,配套探索类项目的长期评估机制与阶段性支持方式,引导形成容错包容、激励创新的制度环境。在此基础上,实现制度化协同与自由探索的动态均衡,提升跨学科合作体系对颠覆性创新的发现与孕育能力。
附录1 数据来源与数据整合处理 1. 数据来源本研究数据来源于智创数据集[41]。智创数据集(Intelligent Innovation Dataset)是由复旦大学社会智能研究中心、博观创新(上海)大数据科技有限公司以及上海人工智能实验室共同开源的大规模学术成果数据库。广泛地涵盖了科研成果和专利相关数据,目前主要包括学术论文、科研项目、专利等多种类型的学术成果数据。智创数据库中一共包含六张表,分别是论文表、论文引用关系表、基金表、基金关系表、专利表和专利法律状态表。本研究主要使用论文表和论文引用关系表(见附表1、附表2)。基于附表1和附表2,本研究使用了论文的eid、作者id信息、作者的合作关系、文献的一级学科归属信息,以及论文之间的引用关系等信息。
|
表 1 论文表 |
|
|
表 2 论文引用关系表 |
|
|
表 3 学科缩写与全称对照表 |
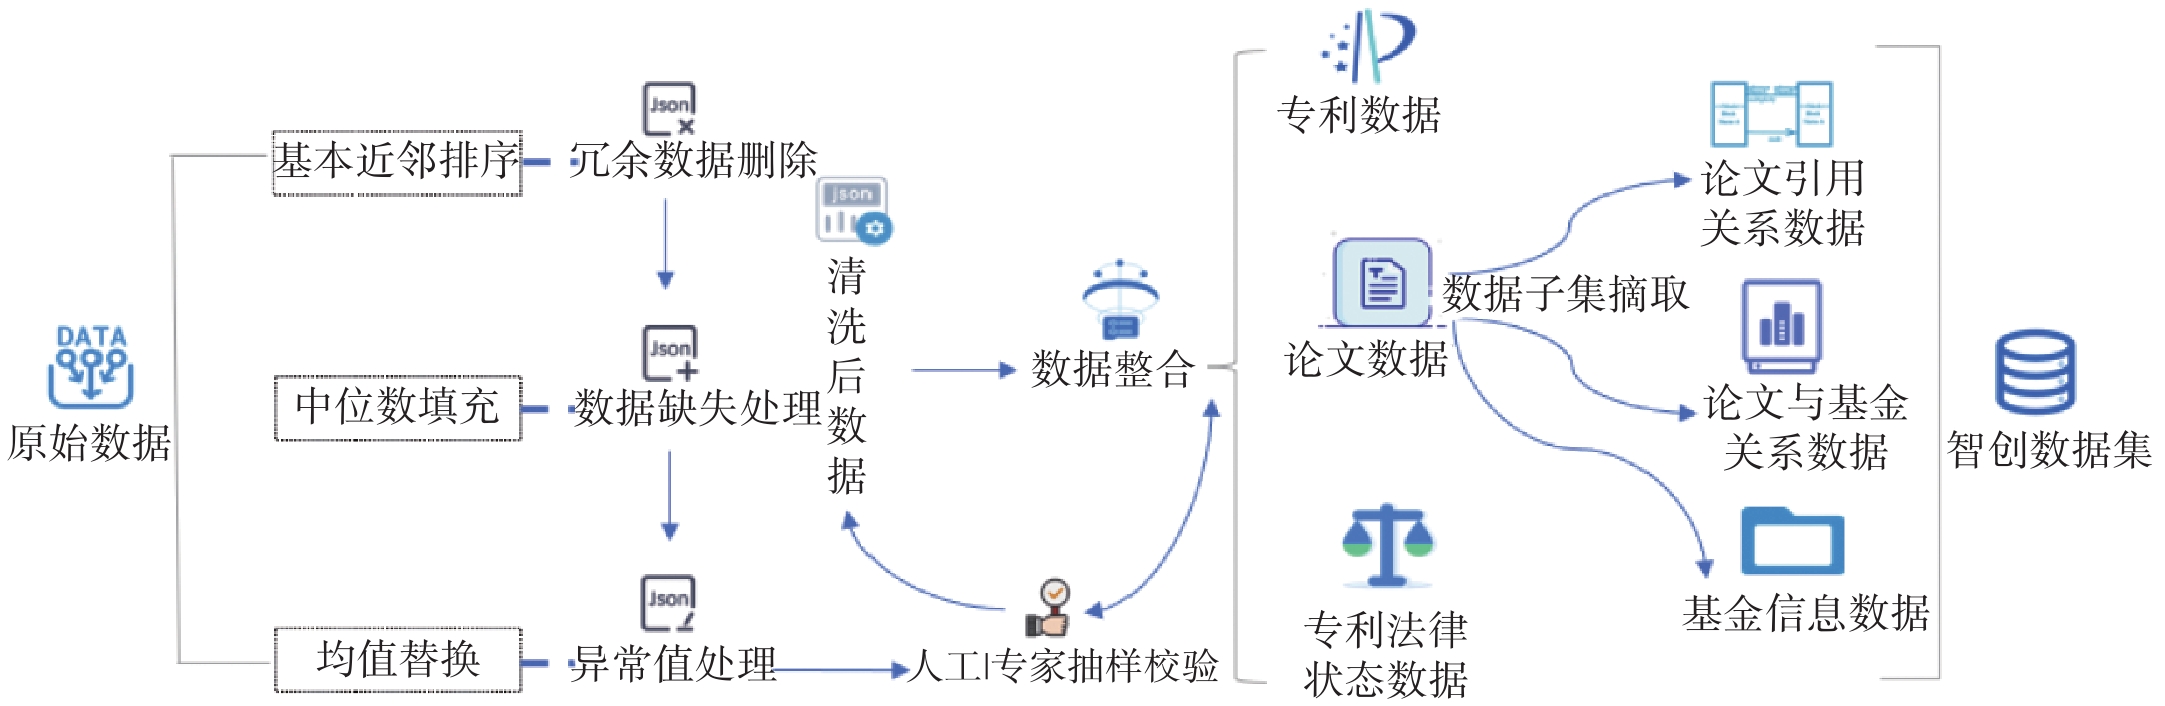
为保证数据的规范性,该数据集对数据进行了清洗、整合处理,以保证数据质量满足要求,具体流程见附图1。主要数据处理手段包括冗余数据处理、数据缺失处理、异常值处理、数据整合、数据子集摘取。
|
图 1 数据处理流程图 |
(1)冗余数据处理:根据数据标准要求,对输入的数据字段进行比对判别,将重复冗余字段和数据自动删除。
(2)数据缺失处理:由于系统异常、人工录入失误等因素,可能存在某些记录缺失,针对此情况提供灵活的数据补足方式。
(3)异常值处理:根据判定规则进行数据的自动判断与处理,支持设置业务规则,并按照业务规则进行处理,如将异常值剔除,或者设为均值等等。
(4)数据分类整合:对论文、专利等不同类型数据进行整合处理解决重复性、一致性、唯一性问题。
附录2 数据结果统计附表
|
图 2 作者数量平滑分布图 |
附图3展示了基于Gap Statistic方法所计算的Gap Value和Diff value随聚类数K的变化。Gap Value用于衡量真实聚类结构与随机聚类结构之间的差异,值越大表示聚类效果越显著。图中可以清晰观察到,Gap Value在K=4时达到最大值(红点标注),说明此时数据聚类效果最好,最具结构性。Diff Value用于判断Gap Value是否在当前K后趋于稳定或显著下降。图中显示,当K=4时,Diff Value > 0,说明Gap在此点已经不再显著提升,符合“1-SE规则(使用Gap Statistic方法选择最优聚类数K时常用的判断准则,选择使得Gap值首次达到:最大Gap值减去其标准误差的最小K)”所建议的拐点判断。
|
图 3 聚类数与Gap Value和Diff Value关系图 |
轮廓系数越高,表示聚类结构越紧凑、分离越明显。从附图4中可以看出,虽然在K=2时轮廓系数达到最高值,但从实际聚类的语义可解释性出发,K=4的聚类划分更符合数据的实际结构和语义划分,且K=4时轮廓系数也表现良好(为除K=2以外的峰值),便于理解和后续应用。
|
图 4 不同K值下的轮廓系数变化图 |
|
|
表 4 不同学科组合的论文数量占比统计表(年度前五) |
|
|
表 5 排名前五的学科组合JBS得分 |
|
|
表 6 排名前五的学科组合MCC得分 |
|
|
表 7 排名前五的学科组合MAC得分 |
数据可用性声明:本篇论文的关联数据因核心元数据来源于其他数据库,受其版权与许可协议约束,不支持完全公开共享,为不宜公开共享的数据。数据存储在科学数据银行,可依据合理理由依申请获取,数据获取申请链接:https://cstr.cn/31253.11.sciencedb.0139x,https://doi.org/10.57760/sciencedb.0139x。
① Direct URL to data: https://opendatalab.com/Gracie/IIDS.
② 编者注:本文所有附录内容见文章电子版。
③ 智创数据集根据scopus的学科分类观测点,将数据集划分为27个一级学科领域(详见附表3)。具体分类方法详见Wu X, Zou H, Xing Y, et al. Intelligent innovation dataset on scientific research outcomes and patents. Journal of Social Computing, 2025, 6(1): 63−73.
④ subject_id:一级学科编码;pub_year:论文发表年份;minyear:该学者发表的最早年份;maxyear:该学者发表的最晚年份;total_sub_id: 与当前一级学科相关的论文总数;total_asjc: 该学者在该年份发表的论文总数;citednum: 被引用次数;当 subject_id等于13(综合学科)时权重 weight的值为0.1。在其他情况下(即 subject_id 不等于 13)权重weight的值为1。
| [1] |
Wang Q, Schneider J W. Consistency and validity of interdisciplinarity measures.
Quantitative Science Studies, 2020, 1(1): 239-263.
DOI: 10.1162/qss_a_00011. |
| [2] |
Sinatra R, Wang D, Deville P, et al. Quantifying the evolution of individual scientific impact.
Science, 2016, 354(6312): aaf5239.
DOI: 10.1126/science.aaf5239. |
| [3] |
Ramadi K B. Inter-disciplinary collaboration for innovation in gastroenterology.
Nature Reviews Gastroenterology & Hepatology, 2023, 20(12): 757-757.
|
| [4] |
Azoulay P, Graff-Zivin J, Uzzi B, et al. Toward a more scientific science.
Science, 2018, 361(6408): 1194-1197.
DOI: 10.1126/science.aav2484. |
| [5] |
Okamura K. Interdisciplinarity revisited: evidence for research impact and dynamism. Palgrave Communications, 2019, 5(1).
|
| [6] |
Klein J T. Interdisciplinarity: History, Theory, and Practice. Detroit: Wayne State University Press, 1990: 1−331.
|
| [7] |
杨良斌. 跨学科学的理论基础探讨.
图书情报工作, 2011, 55(16): 29-32+41.
|
| [8] |
Aram J D. Concepts of interdisciplinarity: Configurations of knowledge and action.
Human Relations, 2004, 57(4): 379-412.
DOI: 10.1177/0018726704043893. |
| [9] |
Szostak R. The Interdisciplinary Research Process. Case Studies in Interdisciplinary Research, 2012: 3−20.
|
| [10] |
李江. “跨学科性”的概念框架与测度.
图书情报知识, 2014(3): 87-93.
|
| [11] |
Beers P J, Bots P W. Eliciting conceptual models to support interdisciplinary research.
Journal of Information Science, 2009, 35(3): 259-278.
|
| [12] |
Porter A, Rafols I. Is science becoming more interdisciplinary? Measuring and mapping six research fields over time.
Scientometrics, 2009, 81(3): 719-745.
DOI: 10.1007/s11192-008-2197-2. |
| [13] |
Porter A, Cohen A, David Roessner J, Perreault M. Measuring researcher interdisciplinarity.
Scientometrics, 2007, 72(1): 117-147.
DOI: 10.1007/s11192-007-1700-5. |
| [14] |
Xu J, Bu Y, Ding Y, et al. Understanding the formation of interdisciplinary research from the perspective of keyword evolution: A case study on joint attention.
Scientometrics, 2018, 117: 973-995.
DOI: 10.1007/s11192-018-2897-1. |
| [15] |
谢彩霞. 对科学合作促进科学跨学科发展的计量分析.
科技进步与对策, 2007(8): 171-174.
DOI: 10.3969/j.issn.1001-7348.2007.08.051. |
| [16] |
Morillo F, Bordons M, Gómez I. Interdisciplinarity in science: A tentative typology of disciplines and research areas.
Journal of the American Society for Information Science and technology, 2003, 54(13): 1237-1249.
DOI: 10.1002/asi.10326. |
| [17] |
Barthel R, Seidl R. Interdisciplinary collaboration between natural and social sciences–status and trends exemplified in groundwater research.
PloS one, 2017, 12(1): e0170754.
DOI: 10.1371/journal.pone.0170754. |
| [18] |
Renwick C. Biology, social science and history: interdisciplinarity in three directions.
Palgrave Communications, 2016, 2(1): 1-5.
|
| [19] |
王旻霞, 赵丙军. 跨学科知识交流网络结构特征研究.
情报科学, 2016, 34(5): 46-50+104.
DOI: 10.13833/j.cnki.is.2016.05.009. |
| [20] |
杜瑾, 熊回香, 向瀛泓. 基于学术网络的跨学科论文推荐研究.
情报学报, 2024, 43(5): 516-527.
DOI: 10.3772/j.issn.1000-0135.2024.05.002. |
| [21] |
Iacopini I, Milojević S, Latora V. Network dynamics of innovation processes.
Physical review letters, 2018, 120(4): 048301.
DOI: 10.1103/PhysRevLett.120.048301. |
| [22] |
刘佳豪, 宋凯, 李玉莹, 等. 数据集引用视角下的知识领域跨学科性和主题演变研究.
情报理论与实践, 2025, 48(2): 156-167+177.
DOI: 10.16353/j.cnki.1000-7490.2025.02.017. |
| [23] |
Berkes E, Marion M, Milojević S, et al. Slow convergence: Career impediments to interdisciplinary biomedical research.
Proceedings of the National Academy of Sciences, 2024, 121(32): e2402646121.
DOI: 10.1073/pnas.2402646121. |
| [24] |
杨良斌. 跨学科指标测度的数据集构建及数据预处理研究.
图书情报工作, 2013, 57(11): 90-95.
|
| [25] |
Xie Z, Li M, Li J, et al. Feature analysis of multidisciplinary scientific collaboration patterns based on PNAS.
EPJ Data Science, 2018, 7: 1-7.
DOI: 10.1140/epjds/s13688-017-0128-2. |
| [26] |
韩普, 王东波. 跨学科性的理论与实践研究综述.
情报学报, 2014, 33(11): 1222-1232.
DOI: 10.3772/j.issn.10000135.2014.011.011. |
| [27] |
孔晶, 杨媛, 廖倩, 等. 第一个基础教育领域跨学科学习实践研究——基于系统性文献综述法.
现代教育技术, 2024(6): 63-70.
|
| [28] |
张宝生, 张庆普. 基于耗散结构理论的跨学科科研团队知识整合机理研究.
科技进步与对策, 2014, 31(21): 132-136.
DOI: 10.6049/kjjbydc.2014020173. |
| [29] |
唐磊, 刘霓, 高媛, 等. 跨学科研究的理论与实践: 基于研究文献的考察. 北京: 中国社会科学出版社, 2016.
|
| [30] |
Wu X, Zou H, Xing Y, et al. Intelligent innovation dataset on scientific research outcomes and patents.
Journal of Social Computing, 2025, 6(1): 63-73.
DOI: 10.23919/JSC.2024.0033. |
| [31] |
冯志刚, 李长玲, 刘小慧, 等. 基于引用与被引用文献信息的图书情报学跨学科性分析.
情报科学, 2018, 36(3): 105-111.
DOI: 10.13833/j.issn.1007-7634.2018.03.018. |
| [32] |
Liben-Nowell D, Kleinberg J. The link prediction problem for social networks. Proceedings of the twelfth international conference on Information and knowledge management, 2003, 556-559.
|
| [33] |
Fletcher S, Islam M Z. Comparing sets of patterns with the Jaccard index. Australasian Journal of Information Systems, 2018, 22.
|
| [34] |
Tan P N, Steinbach M, Kumar V. Introduction to Data Mining. New Delhi: Pearson Education India, 2016: 1−839.
|
| [35] |
Leydesdorff L. On the normalization and visualization of author co‐citation data: Salton's Cosine versus the Jaccard index.
Journal of the American Society for Information Science and Technology, 2008, 59(1): 77-85.
DOI: 10.1002/asi.20732. |
| [36] |
Bornmann L, Daniel H D. What do citation counts measure? A review of studies on citing behavior.
Journal of documentation, 2008, 64(1): 45-80.
DOI: 10.1108/00220410810844150. |
| [37] |
Wang D, Song C, Barabási A L. Quantifying long-term scientific impact.
Science, 2013, 342(6154): 127-132.
DOI: 10.1126/science.1237825. |
| [38] |
Radicchi F, Fortunato S, Castellano C. Universality of citation distributions: Toward an objective measure of scientific impact.
Proceedings of the National Academy of Sciences, 2008, 105(45): 17268-17272.
DOI: 10.1073/pnas.0806977105. |
| [39] |
Wuchty S, Jones B F, Uzzi B. The increasing dominance of teams in production of knowledge.
Science, 2007, 316(5827): 1036-1039.
DOI: 10.1126/science.1136099. |
| [40] |
Lee S, Bozeman B. The impact of research collaboration on scientific productivity.
Social studies of science, 2005, 35(5): 673-702.
DOI: 10.1177/0306312705052359. |
| [41] |
Ikotun A M, Ezugwu A E, Abualigah L, et al. K-means clustering algorithms: A comprehensive review, variants analysis, and advances in the era of big data.
Information Sciences, 2023, 622: 178-210.
DOI: 10.1016/j.ins.2022.11.139. |
| [42] |
Kaufman L, Rousseeuw P J. Finding Groups in Data: An Introduction to Cluster Analysis. Hoboken: John Wiley & Sons, 2009: 1−368.
|
| [43] |
Alam M S, Rahman M M, Hossain M A, et al. Automatic human brain tumor detection in MRI image using template-based K means and improved fuzzy C means clustering algorithm.
Big Data and Cognitive Computing, 2019, 3(2): 27.
DOI: 10.3390/bdcc3020027. |
| [44] |
Nanda S J, Gulati I, Chauhan R, et al. A K-means-galactic swarm optimization-based clustering algorithm with Otsu’s entropy for brain tumor detection.
Applied Artificial Intelligence, 2019, 33(2): 152-170.
DOI: 10.1080/08839514.2018.1530869. |
| [45] |
Nandapala E Y, Jayasena K P. The practical approach in Customers segmentation by using the K-Means Algorithm. In2020 IEEE 15th international conference on industrial and information systems (ICIIS), 2020, 344-349.
|
| [46] |
Jain A K. Data clustering: 50 years beyond K-means.
Pattern recognition letters, 2010, 31(8): 651-666.
DOI: 10.1016/j.patrec.2009.09.011. |
| [47] |
Tibshirani R, Walther G, Hastie T. Estimating the number of clusters in a data set via the gap statistic.
Journal of the royal statistical society: series b (statistical methodology), 2001, 63(2): 411-423.
DOI: 10.1111/1467-9868.00293. |
| [48] |
Rousseeuw P J. Silhouettes: a graphical aid to the interpretation and validation of cluster analysis.
Journal of computational and applied mathematics, 1987, 20: 53-65.
DOI: 10.1016/0377-0427(87)90125-7. |
| [49] |
李智恒, 桂颖溢, 杨志豪, 等. 基于生物医学文献的化学物质致病关系抽取, 计算机研究与发展, 2018, 55(1): 198-206. DOI: 10.7544/issn1000-1239.2018.20160893.
|
| [50] |
Javier Yanes. Más de 3.600 científicosconstruyen un manual de todas las célulashumanas: “Un Google Maps de la biología”. ELPAÍS, 2024. DOI: https://elpais.com/ciencia/2024-11-20/mas-de-3600-cientificos-construyen-un-manual-de-todas-las-celulas-humanas-un-google-maps-de-la-biologia.html.
|
| [51] |
Thompson L R, Sanders J G, McDonald D, et al. A communal catalogue reveals Earth’s multiscale microbial diversity.
Nature, 2017, 551(7681): 457-463.
DOI: 10.1038/nature24621. |
| [52] |
Gilbert J A, Jansson J K, Knight R. Earth microbiome project and global systems biology.
MSystems, 2018, 3(3): 10-1128.
|
| [53] |
Stephens N, Khan I, Errington R. Analysing the role of virtualisation and visualisation on interdisciplinary knowledge exchange in stem cell research processes.
Palgrave Communications, 2018, 4(1): 1-3.
DOI: 10.1057/s41599-017-0055-7. |
| [54] |
Freiband A, Dickin K L, Glass M, et al. Undisciplining the university through shared purpose, practice, and place.
Humanities and Social Sciences Communications, 2022, 9(1): 172.
DOI: 10.1057/s41599-021-01017-z. |
2. Shanghai Artificial Intelligence Laboratory;
3. Network & Information Center, Shanghai Jiao Tong University;
4. School of Social Development and Public Policy, Fudan University;
5. Applied Mathematics and Computational Sciences, Duke Kunshan University;
6. Institute of Computer Science, University of Göttingen;
7. Research Center for Social Intelligence, Fudan University